
Локальная модель под агентом первые полчаса работает бодро. Потом контекст доходит до сотого вызова инструментов, и дальше либо три слова в секунду, либо ошибка памяти. Первый ответ, который приходит в голову: карта маловата. И вы идёте смотреть, сколько стоит следующая.
Я видел этот сюжет на своей машине и в десятке чужих разборов. «Карта маловата» отвечает на вопрос «сколько». Чтобы выбрать модель, карту и длину контекста осознанно, нужен ответ на другой вопрос: что именно занимает видеопамять, когда модель работает, и почему одна из этих частей растёт, пока вы разговариваете.
Дальше разбираю, из чего складывается счёт и как устроен кеш, который его раздувает. Кто этот кеш заполняет и почему «не влезло» ощущается как обрыв. Три способа платить за память меньше, с ценой каждого. И что из этого следует, когда вы выбираете, что и на чём запускать.
Две части счёта
Видеопамять под работающую модель занята двумя разными вещами, и они ведут себя по-разному.
Первая часть: веса. Это сама модель, миллиарды чисел, которые она выучила. Веса лежат неподвижно. Они одинаковы на первом токене разговора и на миллионном. Цифра на файле модели говорит именно про них: восемь миллиардов параметров в четырёх битах занимают около пяти гигабайт, и больше не станут.
Вторая часть: разговор. Всё, что модель держит перед глазами, пока отвечает: ваши сообщения, вывод инструментов, её собственные рассуждения. В терминах это контекст, и он не лежит в памяти как текст. Он лежит как кеш внимания, набор чисел на каждый токен. Этот набор растёт с каждым токеном, который добавляется в разговор.
Поверх обеих частей идёт запас: служебные буферы движка, промежуточные вычисления, потери от фрагментации. Обычно 15–20% сверху.
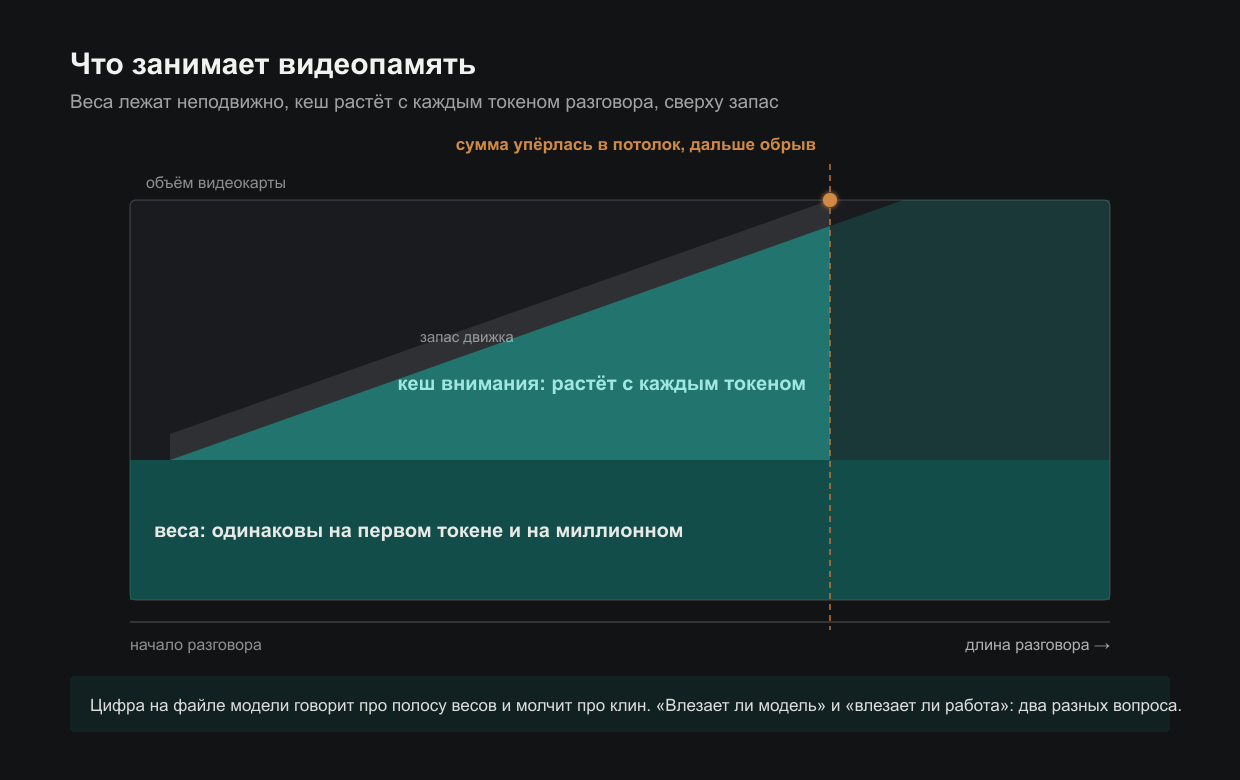
Отсюда первая практическая вещь. Цифра на файле молчит про вторую часть. Две машины с одинаковой моделью ведут себя одинаково на «привет» и совершенно по-разному на сотом вызове инструментов. «Привет» это веса плюс почти ничего. Сотый вызов это веса плюс сотни тысяч токенов кеша. Влезает ли модель, вопрос про веса. Влезает ли работа, вопрос про кеш, и его обычно не задают.
Почему разговор вообще занимает память
Здесь нужно заглянуть внутрь, иначе всё дальнейшее будет набором правил без причины.
Модель отвечает по одному токену за шаг. Чтобы выбрать следующий, ей нужно посмотреть на все предыдущие, на весь контекст от системного промпта до последнего слова. Так устроено внимание: каждый новый токен соотносится с каждым старым.
Что делать с этим «посмотреть на все предыдущие» на каждом шаге? Вариантов два.
Первый: пересчитывать. На каждом шаге заново прогонять весь контекст, строить для каждого старого токена то представление, которое нужно вниманию, и только потом выбирать следующий. Это работает, но объём вычислений растёт с квадратом длины. На тысячном токене вы пересчитываете тысячу, на стотысячном сто тысяч, и так на каждом шаге ответа.
Второй: запомнить. Один раз посчитать для каждого токена то, что вниманию понадобится потом, и положить в память. Следующий шаг ничего не пересчитывает, он читает. Это и есть кеш внимания, KV-кеш: ключи и значения (key, value) для каждого токена на каждом слое модели.
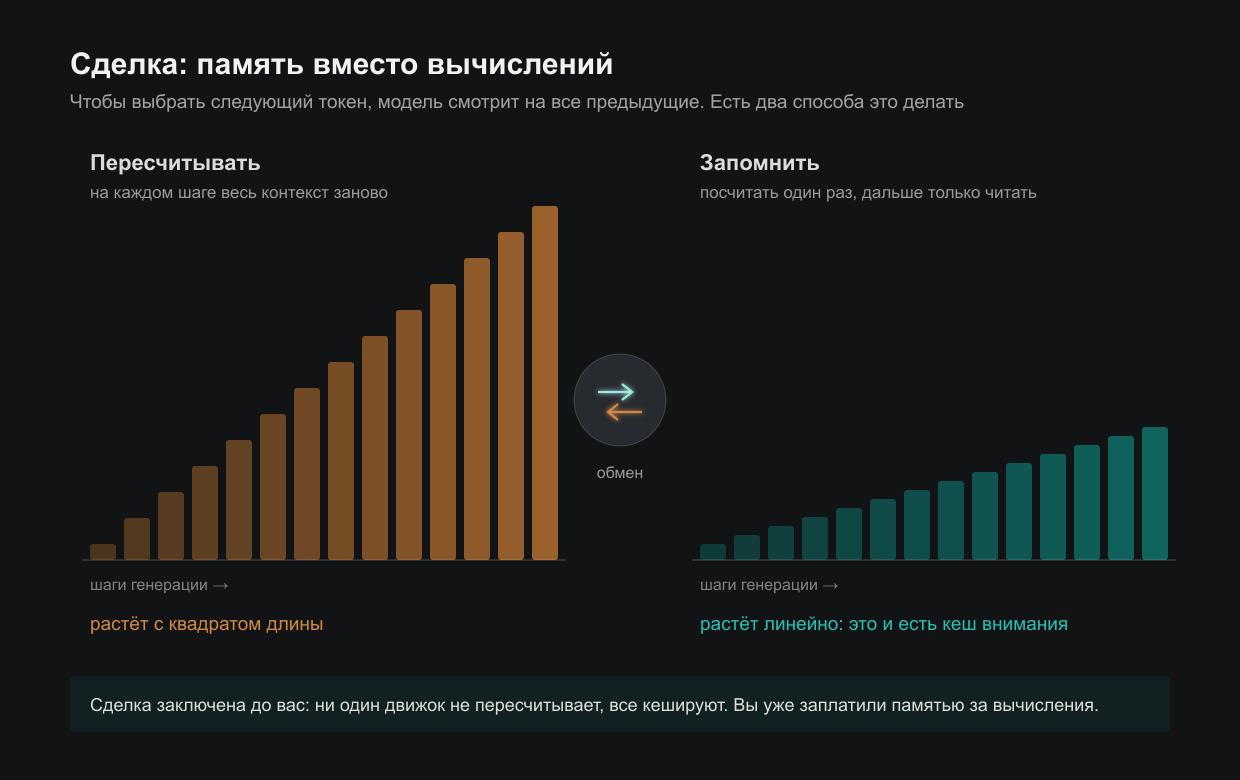
Эта сделка заключена до вас. Ни один современный движок не пересчитывает, все кешируют. Память отдана за то, чтобы не платить вычислениями, и отдана заранее. Вопрос «сколько видеопамяти нужно» на самом деле спрашивает о размере уже выставленного счёта. Всё, что дальше, про то, можно ли этот счёт уменьшить и чем придётся доплатить.
Сколько стоит один токен
У каждого токена в кеше фиксированная цена. Она зависит от устройства модели: сколько слоёв с вниманием, сколько голов на слое, какого размера голова, в какой разрядности числа. От самого токена она не зависит. Слово «и» и слово «эмбеддинг» стоят одинаково.
Поэтому кеш растёт линейно. Каждый следующий токен добавляет столько же, сколько предыдущий, и график расхода по длине разговора получается прямой. Наклон этой прямой и есть цена контекста у конкретной модели. У разных моделей она отличается в разы.
Для масштаба. У типичной восьмимиллиардной модели прошлого года это порядка 128 килобайт на токен в половинной точности. Тридцать две тысячи токенов разговора дают около четырёх гигабайт кеша поверх пяти гигабайт весов. У модели на семьдесят миллиардов та же арифметика на ста двадцати восьми тысячах токенов давала кеш размером с сами веса в четырёхбитном сжатии. Разговор стоил как вторая модель. У моделей этого года наклон другой, и почему, будет ниже.
Для тех, кто считает. Байт на токен = 2 × (число слоёв с полным вниманием) × (число KV-голов) × (размер головы) × (байт на число). Двойка отвечает за ключи и значения. Все множители лежат в карточке модели, обычно в
config.json:num_hidden_layers,num_key_value_heads,head_dimилиhidden_size / num_attention_heads. Умножьте на длину контекста, в которой собираетесь работать, и получите кеш. Добавьте веса в выбранной разрядности и запас, и получите то, что должно поместиться. Одно предупреждение: у гибридных моделей, о которых дальше, в формулу входят только слои с полным вниманием, а не все. Это единственная причина, по которой их кеш в разы меньше.
Кто заполняет разговор
Кажется, что контекст заполняете вы: сообщениями и вставленными документами. В агентной работе это меньшая часть.
Основной поток идёт от инструментов. Агент читает файл, и содержимое падает в контекст. Вызывает команду, и вывод падает в контекст. Один вызов, вывернувший большой лог, стоит дороже вашего диалога за час. Я разбирал эту асимметрию в статье про контекстное окно: вы пишете строчку, а в окно прилетает десять тысяч токенов.
В этом году добавился третий источник, и он самый неочевидный. Модели научились рассуждать перед ответом: строить цепочку промежуточных мыслей, которую вы обычно не видите. У большинства новых открытых моделей режим включён по умолчанию. И эта цепочка идёт в тот же кеш. Модель, которая думает над задачей двенадцать тысяч токенов, занимает под думание столько же памяти, сколько заняли бы двенадцать тысяч токенов вашего текста. У крупной рассуждающей модели прошлого поколения одна такая цепочка стоила порядка четырёх гигабайт.
То есть разговор едят трое: вы, агент и сама модель. Третий едок появился недавно, поэтому старые прикидки его не учитывают, и проверять модель на «привет» бессмысленно. Проверять надо на рабочей длине, с инструментами и с включённым рассуждением.
Почему «не влезло» ощущается как обрыв
До сих пор речь шла о том, сколько занято. У памяти есть второе измерение, и оно объясняет, почему выход за объём ощущается катастрофой.
Память в машине устроена лестницей. Ближе всего к вычислительным ядрам лежит самая быстрая и самая маленькая. Ступенью ниже видеопамять карты. Ещё ниже оперативная память компьютера, до которой карта добирается через шину. В самом низу диск. Между соседними ступенями пропускная способность отличается примерно на порядок.
Пока модель целиком, с весами и кешем, сидит на одной ступени, генерация идёт со скоростью этой ступени. Как только часть переваливает на следующую, каждый шаг генерации ходит туда за своим куском, и весь конвейер ждёт самого медленного участника. Отсюда обрыв вместо плавного замедления. В замерах, которые я видел этой осенью, одна и та же модель в одной разрядности давала сорок с лишним токенов в секунду, пока лежала на карте целиком. Выселенная на процессор целиком, она давала меньше трёх. Между этими точками нет ровного спуска: последние несколько слоёв, переехавшие через шину, стоят больше, чем все предыдущие вместе.
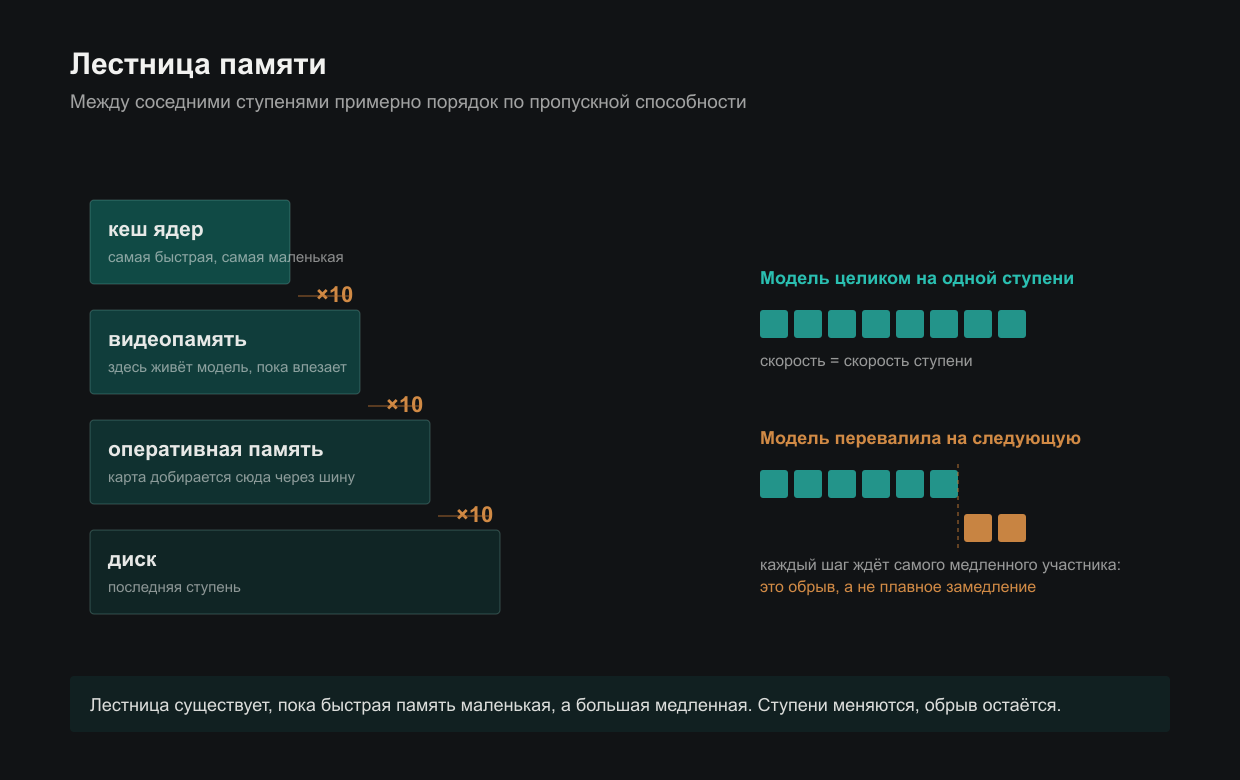
Лестница существует, потому что быстрая память дорогая и маленькая, а большая медленная. Ступени меняются от поколения к поколению. Обрыв остаётся, пока есть лестница. На машинах с общей памятью (Mac, мини-станции на одном чипе) шины между картой и оперативной памятью нет, и обрыва в этом виде тоже нет. Там своя стена: система отдаёт видеоядру только часть общей памяти, по умолчанию около трёх четвертей, и длинный разговор упирается в этот потолок так же внезапно.
И ещё одна асимметрия, объясняющая половину бытовых наблюдений. Чтение промпта и генерация ответа упираются в разное. Когда модель читает длинный вход, она обрабатывает все токены разом. Это вычисления, и они растут с квадратом длины. Когда генерирует, она выдаёт по токену за шаг, и каждый шаг перечитывает весь кеш. Это пропускная способность памяти, вычисления тут почти простаивают. Поэтому машина с широкой шиной и скромными вычислениями летает в коротком чате и долго думает над вставленным документом. Поэтому же новое поколение чипов, добавившее вычислительных блоков, ускорило первый токен в разы, а генерацию на проценты. Две разные стены, и упираться вы будете то в одну, то в другую.
Три способа платить меньше, и чем платят
Раз кеш это сделка, её условия можно пересматривать. За два года индустрия перепробовала три хода. Часть из них живёт в настройках вашего движка, часть в свойствах модели, которые вы выбираете вместе с ней. У каждого есть цена, и для каждого она доказана.
Хранить меньше на токен
Самый прямой ход, и единственный, который целиком в ваших руках. Раз каждый токен стоит фиксированное число байт, уменьшите число байт. Хранить ключи и значения не в половинной точности, а в восьми битах, в четырёх. Или хранить сжатую проекцию, из которой они восстанавливаются на лету: так устроено внимание у нескольких крупных моделей. Или выбрасывать токены, к которым внимание давно не обращалось.
Это работает. Кеш в восьми битах почти неотличим от полного, и это флаг в движке, который стоит включить сразу. Четыре бита на большинстве задач тоже держатся. Новейшие схемы сжимают до трёх бит без заметной потери на бенчмарках и уже просачиваются в домашние движки.
Цена здесь точность припоминания, и у неё есть предел. Работа этого лета вывела нижнюю границу ошибки при сжатии кеша в заданное число раз. Границу задаёт разнообразие будущих вопросов к этому контексту, а модель тут ни при чём. Если запросы к сжатому кешу предсказуемы, сжимать можно почти без потерь. Если нет, платите полную цену, и никакой алгоритм её не снимет. Это нижняя граница, а не недоработка.
И у этой цены есть форма, которую в отчётах не видно. Когда кеш сжимают или выбрасывают старые токены, средний результат на бенчмарках почти не двигается. Это радует и усыпляет. Работа с одной из главных конференций года отложила средний балл и посмотрела на отдельные инструкции. Деградация оказалась неравномерной. Большинство инструкций переживают сжатие нормально, некоторые проседают катастрофически: модель просто перестаёт их видеть. Разобранный случай касается системного промпта. Правила поведения стоят в самом начале контекста, значит, это самые старые токены и первые кандидаты на выселение. Бенчмарк меряет ответы на вопросы, а инструкция «не раскрывай системный промпт» тем временем вымылась из кеша.
Практическое следствие простое: сжатие кеша проверять инструкцией из начала контекста. Средний балл её не ловит. Включили сжатие, положите в начало правило и на длинном разговоре убедитесь, что модель его всё ещё выполняет.
Хранить у меньшего числа слоёв
Формула умножает на число слоёв с полным вниманием. Уменьшите множитель. Это уже не настройка, это свойство модели, и вы выбираете его, выбирая модель.
Так устроены гибриды, самое заметное, что произошло с открытыми моделями за год. Полное внимание, которое оглядывается на весь контекст и требует кеша, оставлено на части слоёв. Остальные работают иначе: держат состояние фиксированного размера, которое не растёт с длиной, и обновляют его на каждом токене. Три-четыре таких слоя на один с полным вниманием, типичная пропорция у моделей этого года. Кеш уменьшается во столько же раз, сколько слоёв лишилось полного внимания. У модели на двадцать семь миллиардов с шестнадцатью слоями внимания из шестидесяти четырёх кеш на токен выходит вдвое меньше, чем у прошлогодней восьмимиллиардной. Вот почему наклон прямой у новых моделей другой.
Того же порядка ход: скользящее окно, когда часть слоёв смотрит только на последние несколько сотен токенов. И общий кеш между слоями, когда несколько слоёв читают одни и те же ключи и значения вместо того, чтобы хранить свои. Разные механики, одна идея: пусть на весь разговор оглядывается не каждый слой.
Цена здесь способность припоминать, и она измерена. Если долю слоёв с полным вниманием уменьшать, поиск по контексту («найди то, что было в тексте раньше») держится до определённой границы. За ней он перестаёт восстанавливаться. Уберите полное внимание совсем, и точность поиска падает к нулю. Пропорция три-четыре к одному существует не потому, что красиво. Дальше ломается. Разработчики нащупали край и встали у края.
Следствие для выбора: у гибрида кеш в разы меньше, и упираться вы будете уже в веса по объёму и в шину по скорости. Смотреть при выборе карты на пропускную способность памяти становится важнее, чем на объём.
Не хранить вообще
Логическое завершение второго хода. Если фиксированное состояние так хорошо работает на трёх слоях из четырёх, почему не на всех? Убрать полное внимание, оставить только состояние, которое не растёт, и получить модель, которой всё равно, сто токенов в разговоре или миллион.
Такие модели есть, и на многих задачах они честно работают. Но полностью вытеснить внимание им не удалось. Причина математическая.
Есть задача, на которой это видно чисто. Дать модели последовательность пар «ключ и значение», а потом в разных местах спрашивать: какое значение было у такого-то ключа? Это множественное припоминание, то самое, что делает модель, когда вспоминает имя переменной со второй страницы кода или условие из начала разговора. Для внимания доказано, что размерность, нужная для этой задачи, не зависит от длины: оно оглядывается назад и находит. Для архитектур с фиксированным состоянием доказано обратное: чтобы решать её точно, состояние должно расти вместе с длиной. Модель с состоянием одного размера не может точно помнить произвольно длинный разговор. Может приблизительно, с потерями, тем большими, чем длиннее.
«Не хранить» не отменяет сделку, оно меняет валюту. Вы перестаёте платить памятью, растущей с длиной, и начинаете платить точностью, падающей с длиной. Гибриды отвечают именно на эту теорему: часть слоёв должна помнить точно, потому что иначе точно не помнит никто.
Одна кривая, три точки
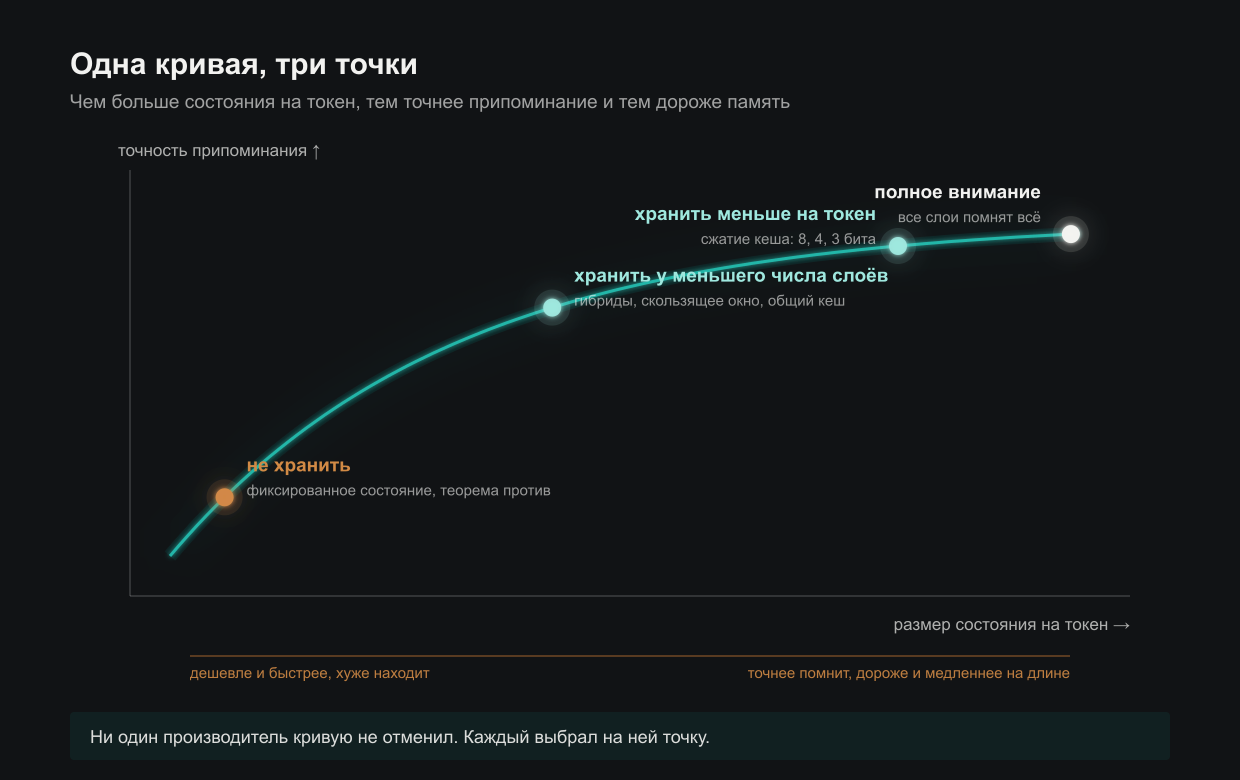
Есть одна ось: сколько состояния модель держит на токен разговора. И одна зависимость: чем больше состояния, тем точнее припоминание, тем дороже память и тем медленнее генерация на длине. Чем меньше, тем дешевле и быстрее, и тем хуже находит.
Все три хода двигаются по этой кривой. Первый сжимает каждую точку, второй убирает часть точек, третий уходит в левый нижний угол. Ни один производитель кривую не отменил. Каждый выбрал на ней точку, и модели этого года стоят левее прошлогодних: дешевле по памяти, с оговорённой платой за это. Модели следующего года встанут ещё левее или найдут, как приподнять кривую. Но она останется, потому что за ней стоит то, что значит «помнить», а это инженерным решением не меняется.
Для читателя из этого следует одно. Вопрос «какой кеш у этой модели» имеет ответ в карточке: посмотрите, сколько у неё слоёв с полным вниманием. А вопрос «чем за него заплатили» имеет ответ на кривой, и его стоит задавать тоже. Модель с дешёвым контекстом помнит его приблизительно. Для одних задач это нормально, для других нет.
Отдельно: когда весов тоже слишком много
Всё выше было про разговор. Но у моделей со смесью экспертов есть свой ход и для весов, и он меняет то, что вообще считается «влезло».
У такой модели на каждом токене работает малая часть параметров, несколько экспертов из десятков. Остальные лежат и ждут своей очереди. Раз так, их можно выселить в оперативную память, оставив на карте только то, что работает всегда: внимание, общие слои и кеш. Обрыва здесь нет, есть склон. На каждом токене через шину идёт малая часть, и это терпимо. Модель на сто двадцать миллиардов параметров запускается на карте с восемью гигабайтами и десятками гигабайт оперативной памяти со скоростью, с которой можно работать.
Для плотных моделей такого выхода нет: у них на каждом токене работает всё, и через шину пришлось бы гонять всё. Отсюда правило. У смеси экспертов считать оперативную память и видеопамять вместе, у плотной модели только видеопамять. И ещё одно: «активные параметры» в описании такой модели говорят про скорость, а не про память. Загружать в память надо всех экспертов, считать только активных.
Какую модель, на какой карте, с каким контекстом
Теперь можно ответить на вопрос, с которого началось. Ответом будет порядок действий, числа здесь не будет.
Сначала длина, потом модель. Определите, в каком контексте вы реально работаете: с инструментами, документами и рассуждением модели. Не «привет», а сотый вызов. Это число ставит всё остальное.
Цену контекста смотреть в карточке, а не в размере. Сколько слоёв с полным вниманием, сколько KV-голов, какого размера голова. Две модели одного размера отличаются по кешу в пять раз, и цифра на файле этого не покажет. Формула во врезке выше занимает минуту.
У гибрида узкое место переезжает. Если кеш в разы меньше, объём карты уже не входной билет. Скорость определяет пропускная способность памяти. Выбирая между картой побольше и картой пошустрее, под гибрид берите вторую.
У смеси экспертов считать RAM и VRAM вместе. И не бояться моделей, которые «не влезают»: эксперты живут в оперативной памяти, на карте остаются внимание и кеш.
Сжатие кеша включить и проверить инструкцией. Восемь бит почти бесплатно и почти всегда. Четыре бита с проверкой, что правило из начала контекста доживает до конца разговора.
Не платить дважды за одно и то же. В агентной петле системный промпт и описания инструментов одинаковы на каждом шаге. Движки умеют переиспользовать уже посчитанный кеш для общего начала, это называется кешированием префикса. Включённое, оно снимает пересчёт того, что не менялось, и это единственная бесплатная экономия во всей статье.
Для тех, кто считает. Три настройки, которые двигают счёт сильнее прочих. Длина контекста: не полагайтесь на дефолт. Популярные движки ставят его от размера видеопамяти, и на картах младше двадцати четырёх гигабайт он может оказаться в четыре тысячи токенов без предупреждения. Правда видна только в логе. Выставляйте под рабочую длину руками. Разрядность кеша: отдельные флаги для ключей и значений, восемь бит как стартовая точка. Что оставлять на карте: у смеси экспертов есть флаг, сколько слоёв экспертов выселить на процессор. Начинать с того, чтобы на карте помещались внимание и кеш на вашу длину. Остальное наружу.
Куда это движется
Здесь начинается моя оценка, помечаю честно.
Направление одно, и оно видно по релизам: цена перекладывается всё дальше от пользователя. Гибриды стали нормой для новых открытых моделей, теперь удивляет модель, у которой полное внимание на всех слоях. Сжатие кеша уходит в три бита и становится настройкой движка, а не исследовательской темой. Кеш учатся держать вне видеопамяти: в оперативной, на диске, на отдельных ускорителях. Лестница удлиняется снизу, а не укорачивается.
И всё это на фоне того, что память как товар дорожает и заканчивается. Глава SK Hynix летом сказал, что следующий год будет худшим в истории отрасли с точки зрения предложения, а спрос останется выше предложения и после 2030-го. Для владельца локальной машины это значит простую вещь: «доложу памяти потом» перестало быть планом. Архитектурная экономия единственная, которая дешевеет.
Свою позицию сформулирую без дат. Пока внимание оглядывается назад, состояние надо где-то держать. Это следует из теоремы, а не из состояния технологий. Меняется, где его держат и с какой точностью. Модель, у которой разговор бесплатен, будет моделью, которая помнит его приблизительно. Это условие, а не изъян. Вопрос при выборе звучит так: какую точку на кривой выбрала модель и подходит ли эта точка под вашу задачу. «Какая лучше» на него не отвечает.
Закрытие
Видеопамять под локальную модель кончается на разговоре, и это единственная часть счёта, которой вы управляете: длиной, разрядностью, выбором модели, у которой помнят не все слои. Каждый из этих рычагов чем-то оплачен: точностью, скоростью или деньгами за железо. Следующая архитектура поменяет курс. Обмен останется.
Короткие апдейты и разборы — в Telegram-канале Mind & Mesh: @takeshi_ku.