
Модель не помнит предыдущий разговор. И тот, что идёт прямо сейчас, тоже не помнит: каждый раз, когда вы отправляете сообщение, ей заново подкладывают всю переписку с самого начала. Иначе она не поймёт, о чём речь.
Этот объём текста — всё, что модель видит в момент генерации ответа, — называется контекстным окном (context window). Что в него попало, то учитывается. Что не попало, того для модели не существует.
За два года окна выросли примерно в восемь раз. Ещё недавно нормой фронтира были 128 тысяч токенов, сейчас практически весь верхний эшелон держит около миллиона. При этом любой, кто плотно гонял агента, видел, как тот теряет нить: начинает противоречить своим же решениям, заново чинит уже починенное, правит файл по пути, которого давно нет.
Дальше — из чего складывается эта длина, что с ней происходит на самом деле, что из этого следует для повседневной работы и куда всё движется.
Сколько текста помещается в миллион токенов
Модель работает не с буквами и не со словами, а с токенами — кусками, на которые текст разбивает токенизатор. Русскому тут не повезло: кириллица дробится мельче латиницы, и тот же смысл занимает заметно больше места.
Я прогнал два одинаковых по содержанию абзаца, русский и английский, через токенизатор o200k_base:
| символов на токен | токенов на слово | |
|---|---|---|
| Русский | 3,83 | 1,67 |
| Английский | 5,11 | 1,14 |
Русское слово вышло примерно в полтора раза дороже английского. В миллион токенов помещается около 600 тысяч русских слов против 877 тысяч английских — шесть-семь книг среднего размера против девяти-десяти.
Цифры привязаны к конкретному токенизатору и поменяются вместе с ним, так что прикидывайте на своём. Полезнее тут сама привычка проверять: расхожее правило «токен — это примерно четыре символа» пришло из более раннего поколения токенизаторов и на моём замере не подтвердилось ни для одного из двух языков.
Запас кажется бездонным. На практике агент с активными инструментами выедает его на порядок быстрее, чем можно ожидать по числу реплик: несколько команд, вывалив в контекст содержимое больших файлов, съедают сотни тысяч токенов за считаные минуты. Чтобы понять, откуда такая скорость, надо посмотреть, кто вообще претендует на это место.
Из чего состоит окно
Кажется, что окно занято разговором. Разговор там действительно есть, только он не один и обычно не главный.
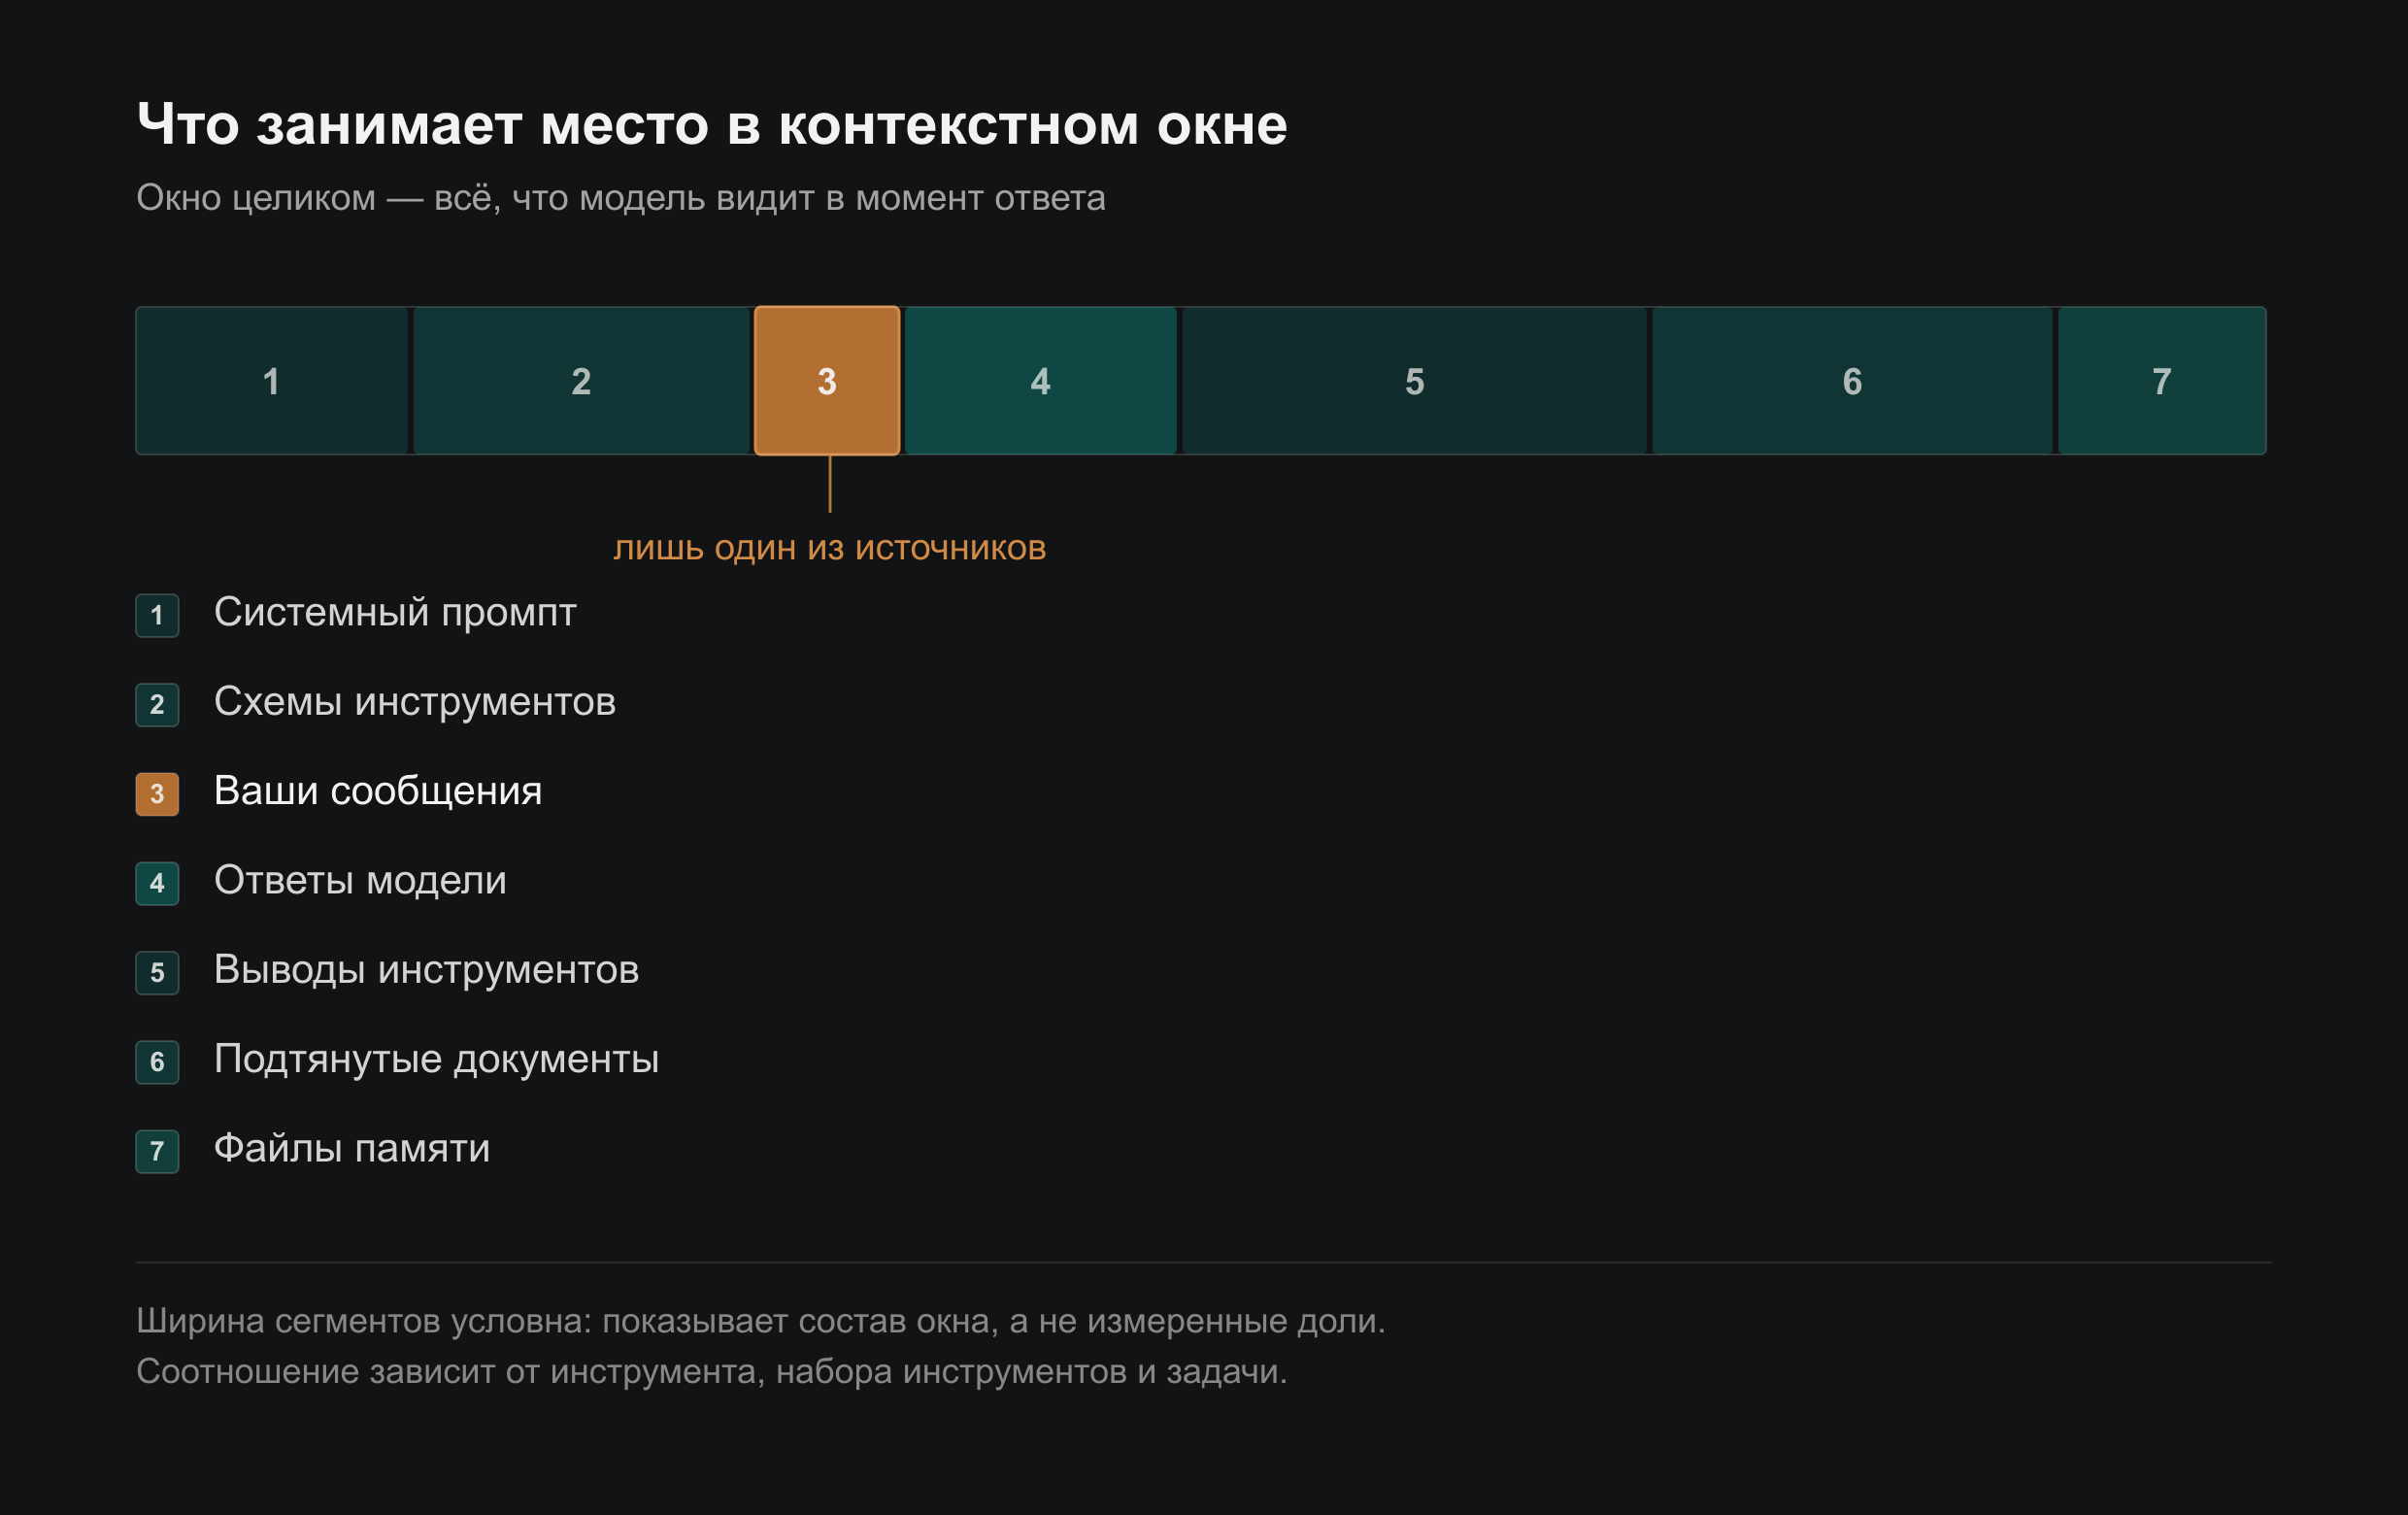
Начать стоит с того, что интерфейс чата создаёт ложное впечатление беседы. Никакой беседы с точки зрения модели нет: интерфейс к модели устроен как набор независимых транзакций. Каждый запрос самодостаточен, модель между запросами ничего не держит, и всё, что должно быть учтено, отправляется заново — целиком, каждый раз.
Отсюда и состав окна. Первым в него попадает системный промпт — инструкции, задающие модели роль, ограничения и формат ответа. Вы их не видите, но едут они в каждый запрос, а не один раз в начале сессии.
Следом идут схемы инструментов (tool schemas) — описание всего, что агент умеет вызывать: как называется инструмент, что делает, какие принимает параметры. Каждый подключённый инструмент добавляет свой кусок описания, и десяток инструментов складывается в заметный расход ещё до того, как вы напишете первое слово.
Только теперь начинается собственно диалог: ваши реплики и ответы модели, накопленные с начала сессии. Это та часть, которую вы видите на экране, и по ней обычно судят о том, сколько «занято».
А вот дальше начинается то, из-за чего окно и кончается так быстро. Как только агент берётся за дело, он вызывает инструменты, и всё, что они возвращают, падает в контекст: содержимое прочитанных файлов, ответы API, результаты поиска, простыни логов. Одна команда, вывалившая большой файл целиком, стоит дороже, чем весь ваш диалог за предыдущий час. Здесь же прячется главная асимметрия работы с агентами: вы пишете строчку, а в окно прилетает десять тысяч токенов.
Если у агента есть поисковый слой, к этому добавляются подтянутые документы. Если есть память — файлы, которые он подгружает на старте: заметки, правила проекта, накопленные факты.
Отдельная статья расходов — картинки. Изображение занимает не «одно сообщение», а свой кусок окна, и разброс между провайдерами тут огромный: одна и та же картинка у одного может уйти в сотню токенов, у другого — в несколько тысяч, потому что считают по-разному и масштабируют по-разному. Общее правило одно: чем выше разрешение, тем дороже. Пара скриншотов в диалоге легко стоит как десяток страниц текста, и это одна из самых незаметных утечек места.
Почему окно вообще конечное
Раз уж место кончается — почему его просто не сделать больше? Упирается в две разные вещи.
Первая — память под кеш. Когда модель обрабатывает текст, она на каждом своём слое считает для каждого токена два набора чисел, ключи и значения (key, value). Они нужны, чтобы каждый следующий токен мог «оглянуться» на все предыдущие. Пересчитывать их заново на каждом шаге генерации было бы расточительно, поэтому их держат в памяти — это и есть KV-кеш.
Объём кеша растёт линейно с длиной контекста, числом слоёв и числом голов внимания. Длиннее вход — больше видеопамяти, и на фронтир-масштабе этот рост обгоняет рост числа параметров самой модели. Работа при этом делится на два этапа: сначала prefill, когда модель обсчитывает весь поданный вход и заполняет кеш, затем decode — генерация ответа по одному токену, каждый из которых обращается к уже посчитанному. Длинный вход бьёт по первому этапу, длинный ответ — по второму.
Вторая причина глубже и памятью не лечится. Внимание устроено так, что каждый токен соотносится с каждым, и число пар растёт квадратично: на ста тысячах токенов это порядка десяти миллиардов попарных связей. Внимание — ограниченный ресурс, распределяемый между всеми ними. Чем длиннее вход, тем меньше веса достаётся каждому отдельному куску.
Инженерия эту стену двигает, и довольно успешно: кеш научились сжимать, храня сжатые проекции вместо полных ключей и значений, и хранить в меньшей разрядности почти без потери качества. Обе линии оптимизации делают длину дешевле — и обе никак не влияют на то, как распределяется внимание.
Что показывают замеры
Проседает не одна ось, а две сразу, и вторую я поначалу упускал из виду.
Ось первая: длина входа
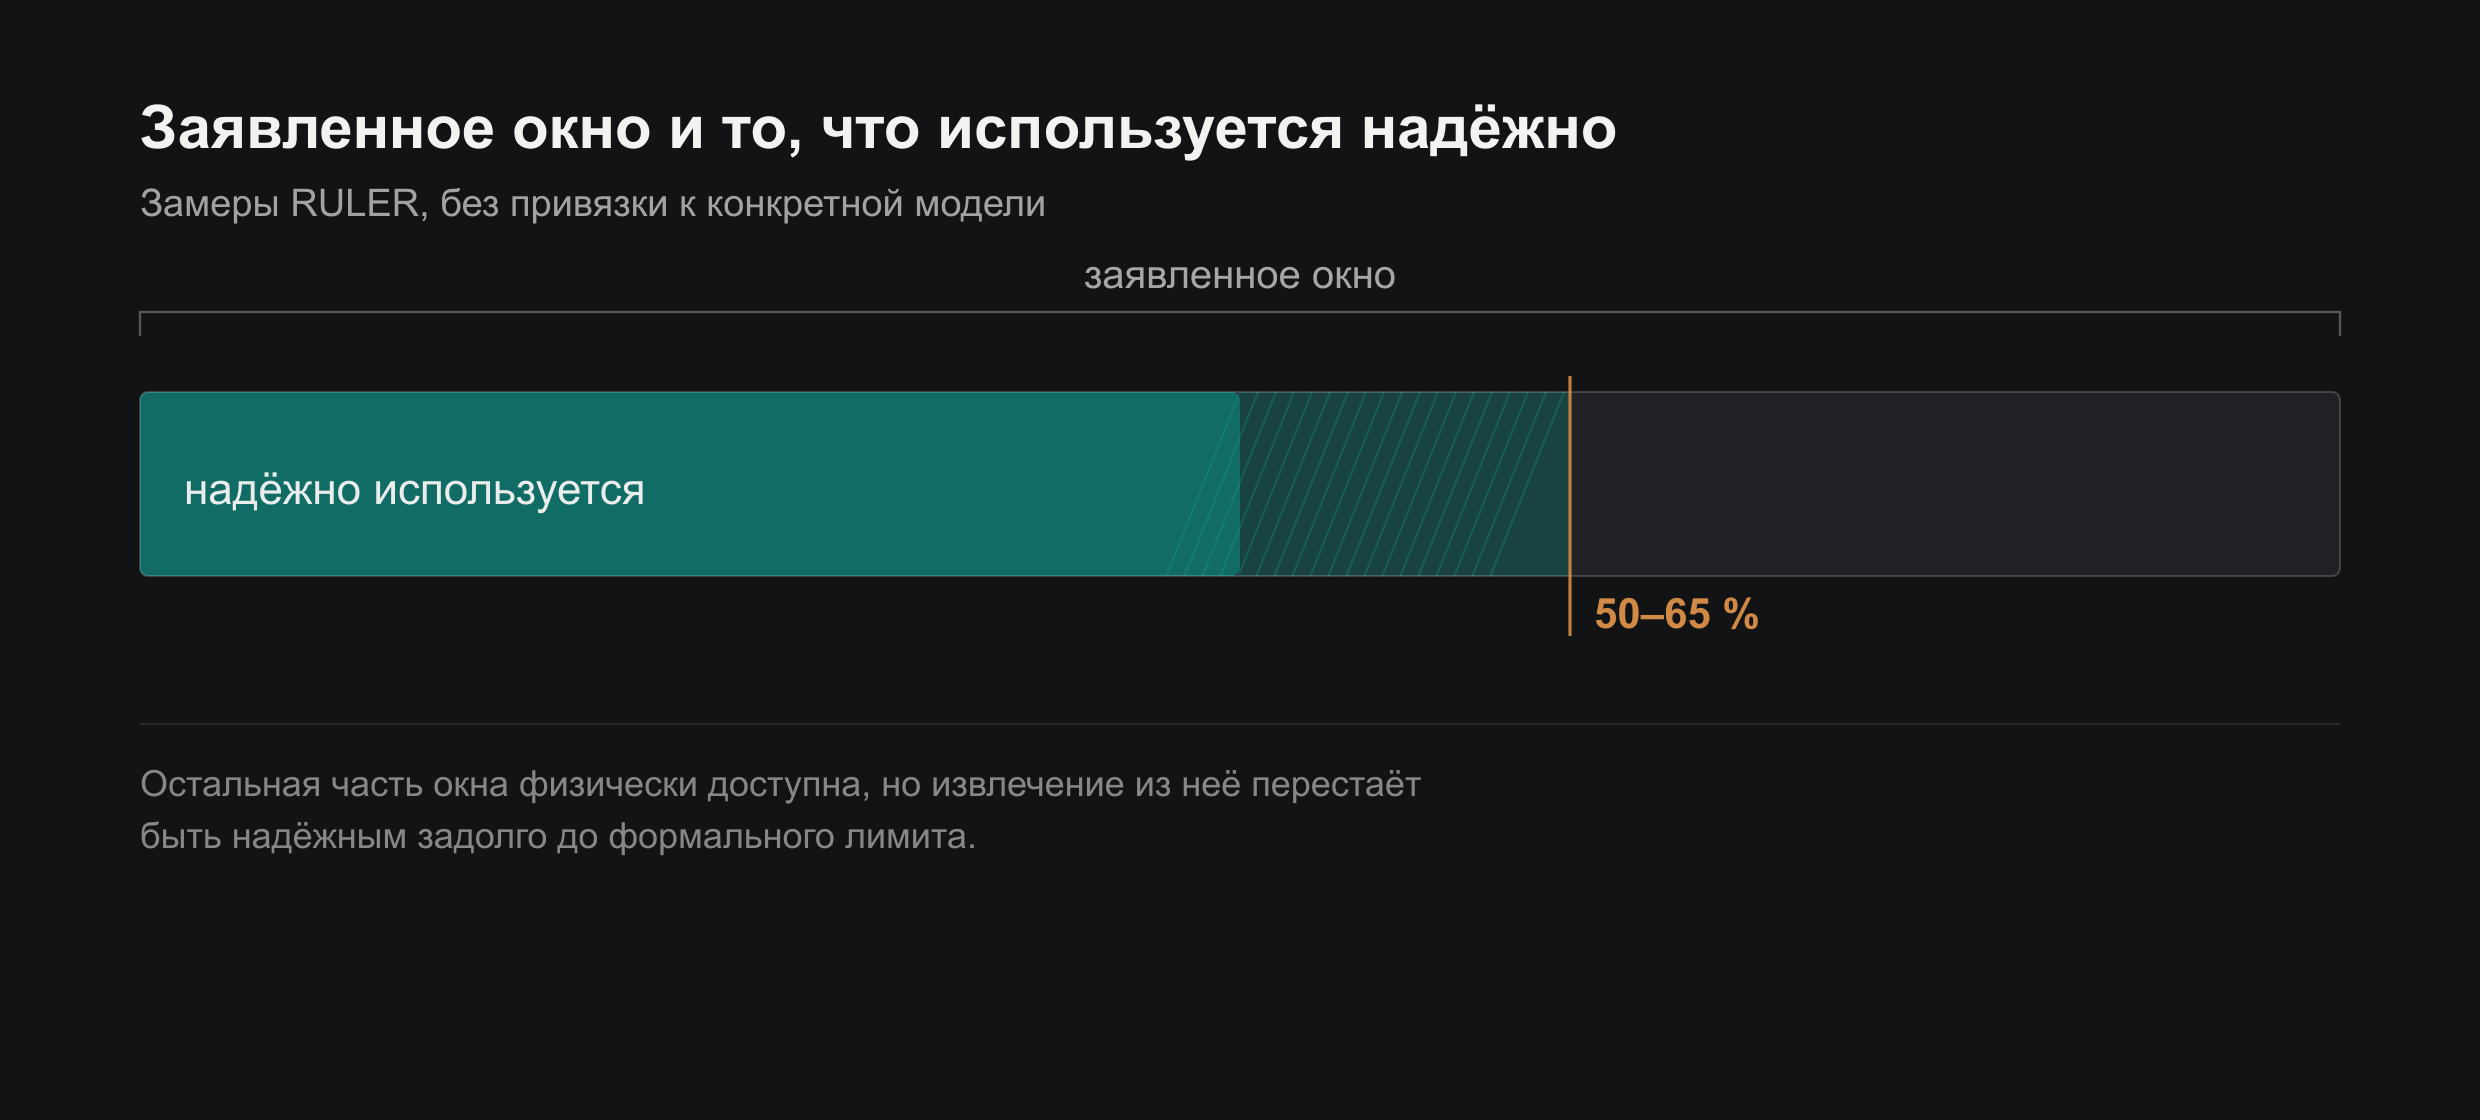
Бенчмарк RULER от NVIDIA даёт устойчивую картину: модели надёжно используют примерно половину-две трети заявленного окна. Миллион токенов на бумаге ведёт себя как 500–650 тысяч на деле. Пропорция держится от поколения к поколению, потому что описывает не конкретную модель, а разрыв между цифрой в описании и цифрой в работе.
Само падение неравномерно. Работа «Lost in the Middle» описала характерную кривую: точность выше всего, когда нужный факт лежит в начале или в конце контекста, и проседает, когда он оказывается в середине. Эффект держится и на моделях, специально обученных под длинный контекст.
Исследование Chroma, названное авторами «context rot», прогнало через это восемнадцать фронтир-моделей. Деградирует каждая, на каждом проверенном шаге увеличения длины, а падение точности доходит до трети-половины задолго до документированного лимита. Механизмов три: та самая потерянная середина, размывание внимания и отвлекающие фрагменты — куски текста, похожие на нужный по смыслу, но к делу не относящиеся. Последние не просто занимают место, они активно уводят модель в сторону, и это прямой аргумент против привычки «оставлю на всякий случай, вдруг пригодится».
Там же обнаружился результат, ломающий интуицию: модели справлялись лучше с перемешанным набором документов, чем с логично связным текстом. Связность сама по себе мешала.
Отсюда же следует, как читать графики про рекордные окна. Тест «найди иголку в стоге сена» модели проходят почти идеально, и он маскирует реальную деградацию: на многошаговых рассуждениях и агрегации те же модели проваливаются резко. Так что заявленный размер окна и размер, на котором модель держит качество, стоит считать двумя разными числами — и второе спрашивать отдельно, на своей задаче.
Ось вторая: форма разговора
Длина — не единственное, что портит результат.
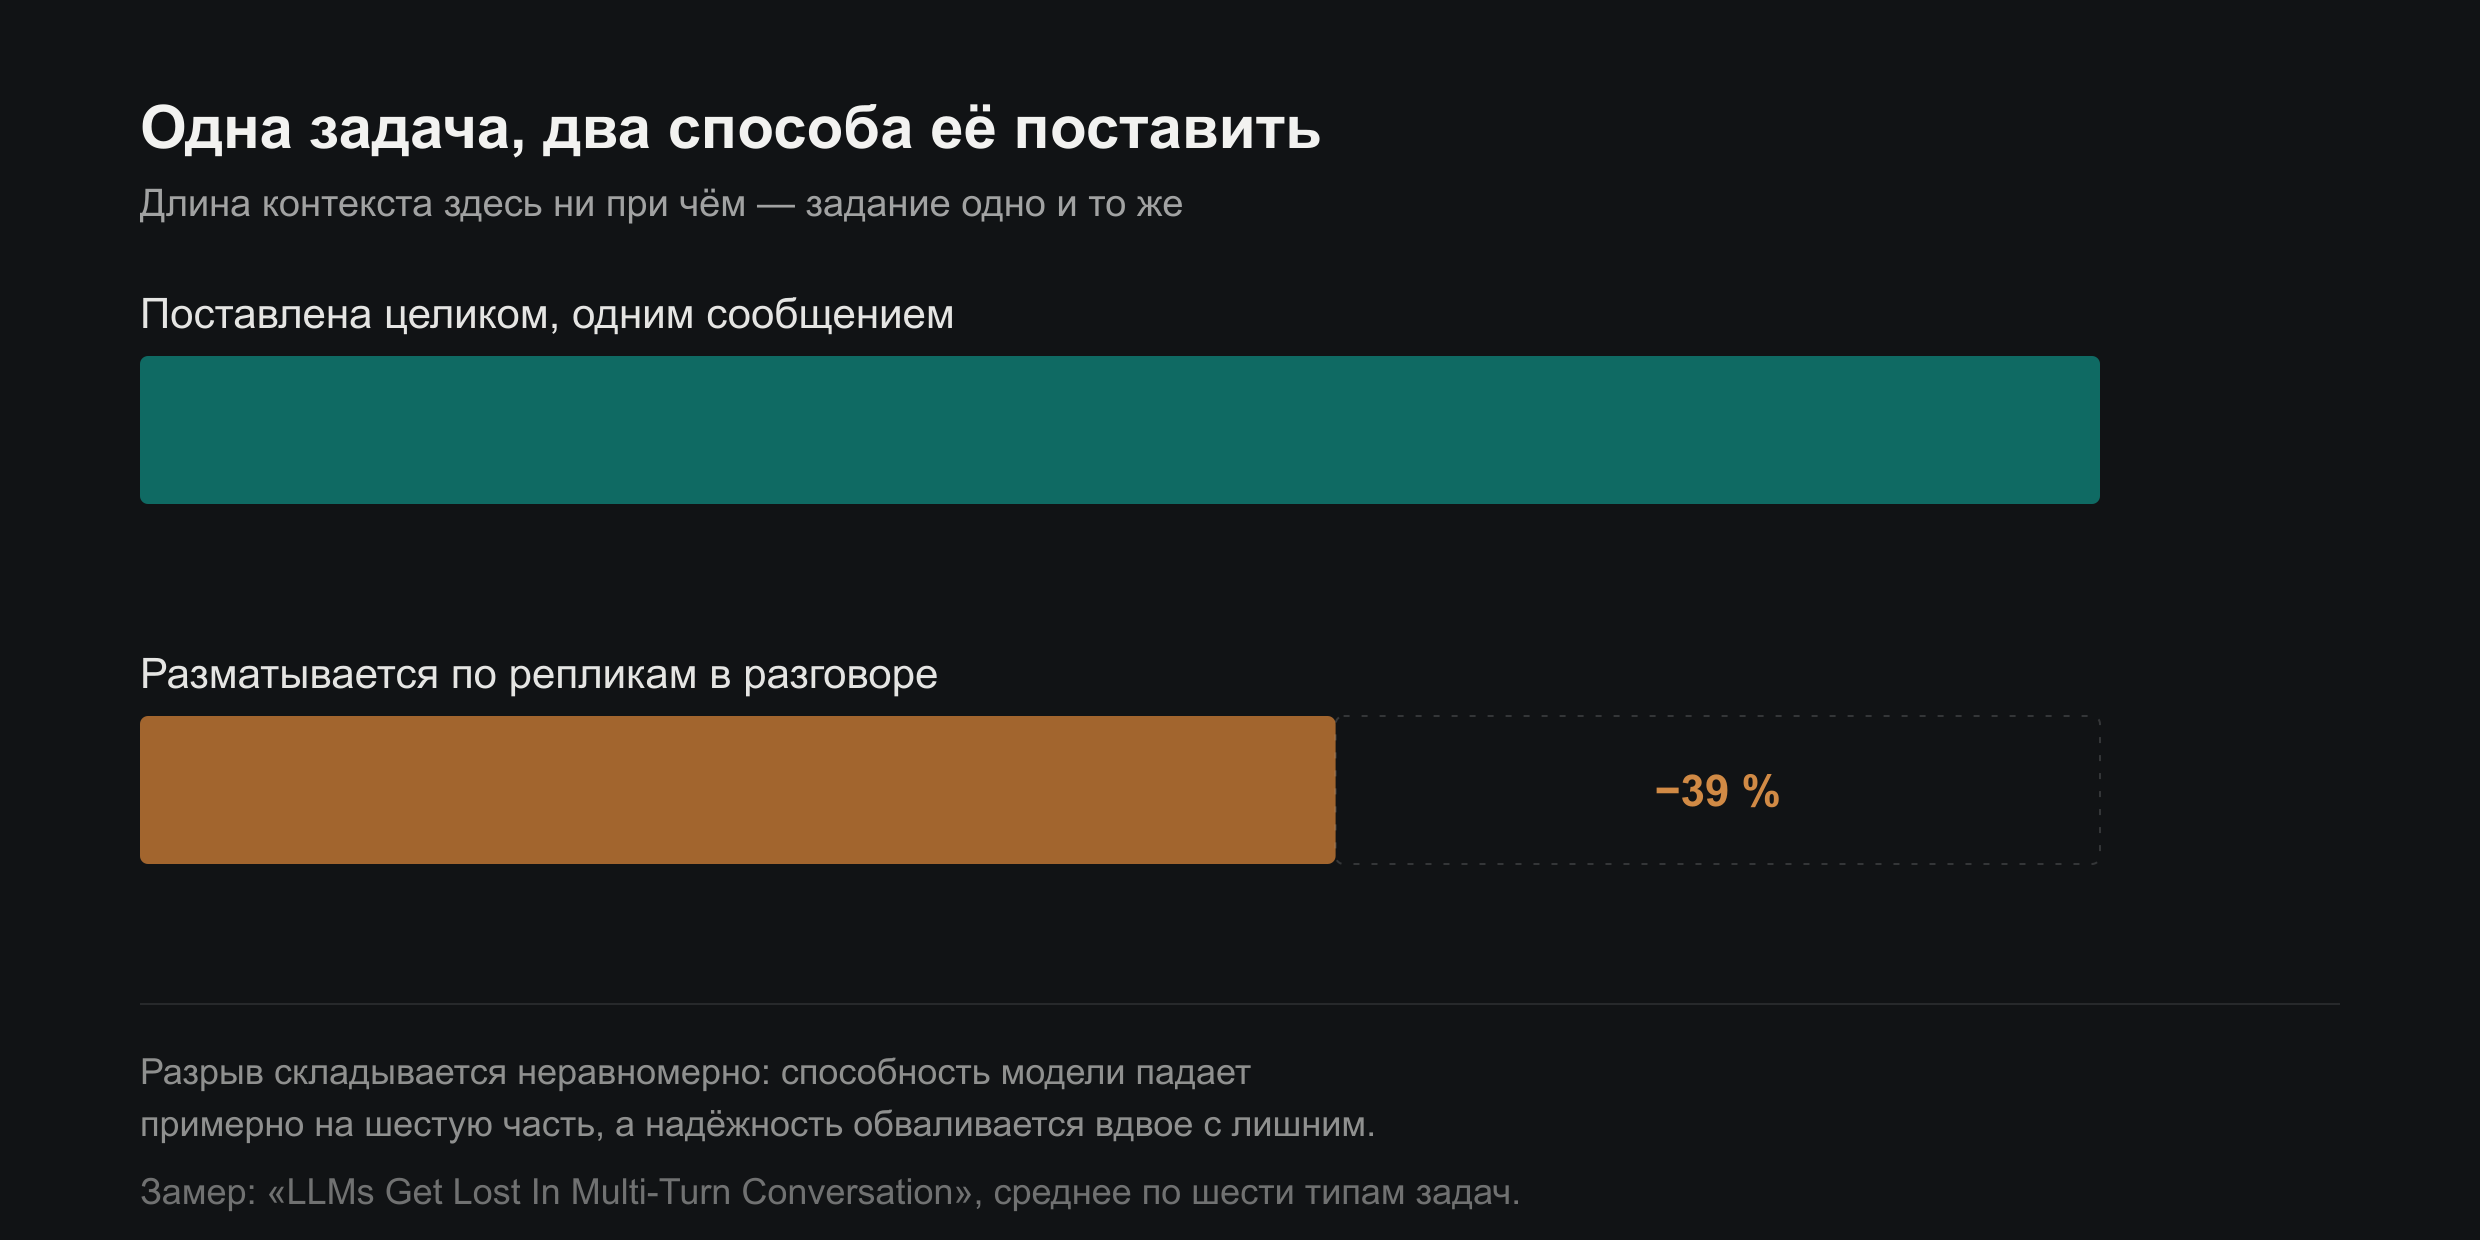
Работа «LLMs Get Lost In Multi-Turn Conversation» (Microsoft Research, устный доклад на ICLR 2026) сравнила два способа поставить одну и ту же задачу: целиком, одним сообщением, — и по частям, разматывая её в разговоре. Разница в среднем составила 39% в пользу целиком поставленной задачи. Длина тут ни при чём: то же самое задание, разбитое на реплики, решается заметно хуже.
Разложение этих 39% интереснее самой цифры. Способность модели падает примерно на шестую часть. А надёжность обваливается вдвое с лишним — то есть разговор по кускам делает модель не столько глупее, сколько дико непредсказуемой. Один и тот же диалог может кончиться и хорошо, и катастрофой.
Механизм авторы описывают так: модель рано делает предположение о том, чего от неё хотят, преждевременно выдаёт решение и дальше цепляется за него. Свернув не туда, она из этого не выбирается. Работа февраля 2026 уточнила корень — расхождение по намерению, а не нехватка способностей.
Когда окно кончается
Дойдя до потолка, агент не останавливается с сообщением «место закончилось». Он сжимает.
Диалог уходит в модель, возвращается пересказом, работа продолжается уже с ним. Один раз это почти безболезненно. Беда в том, что процесс повторяется.
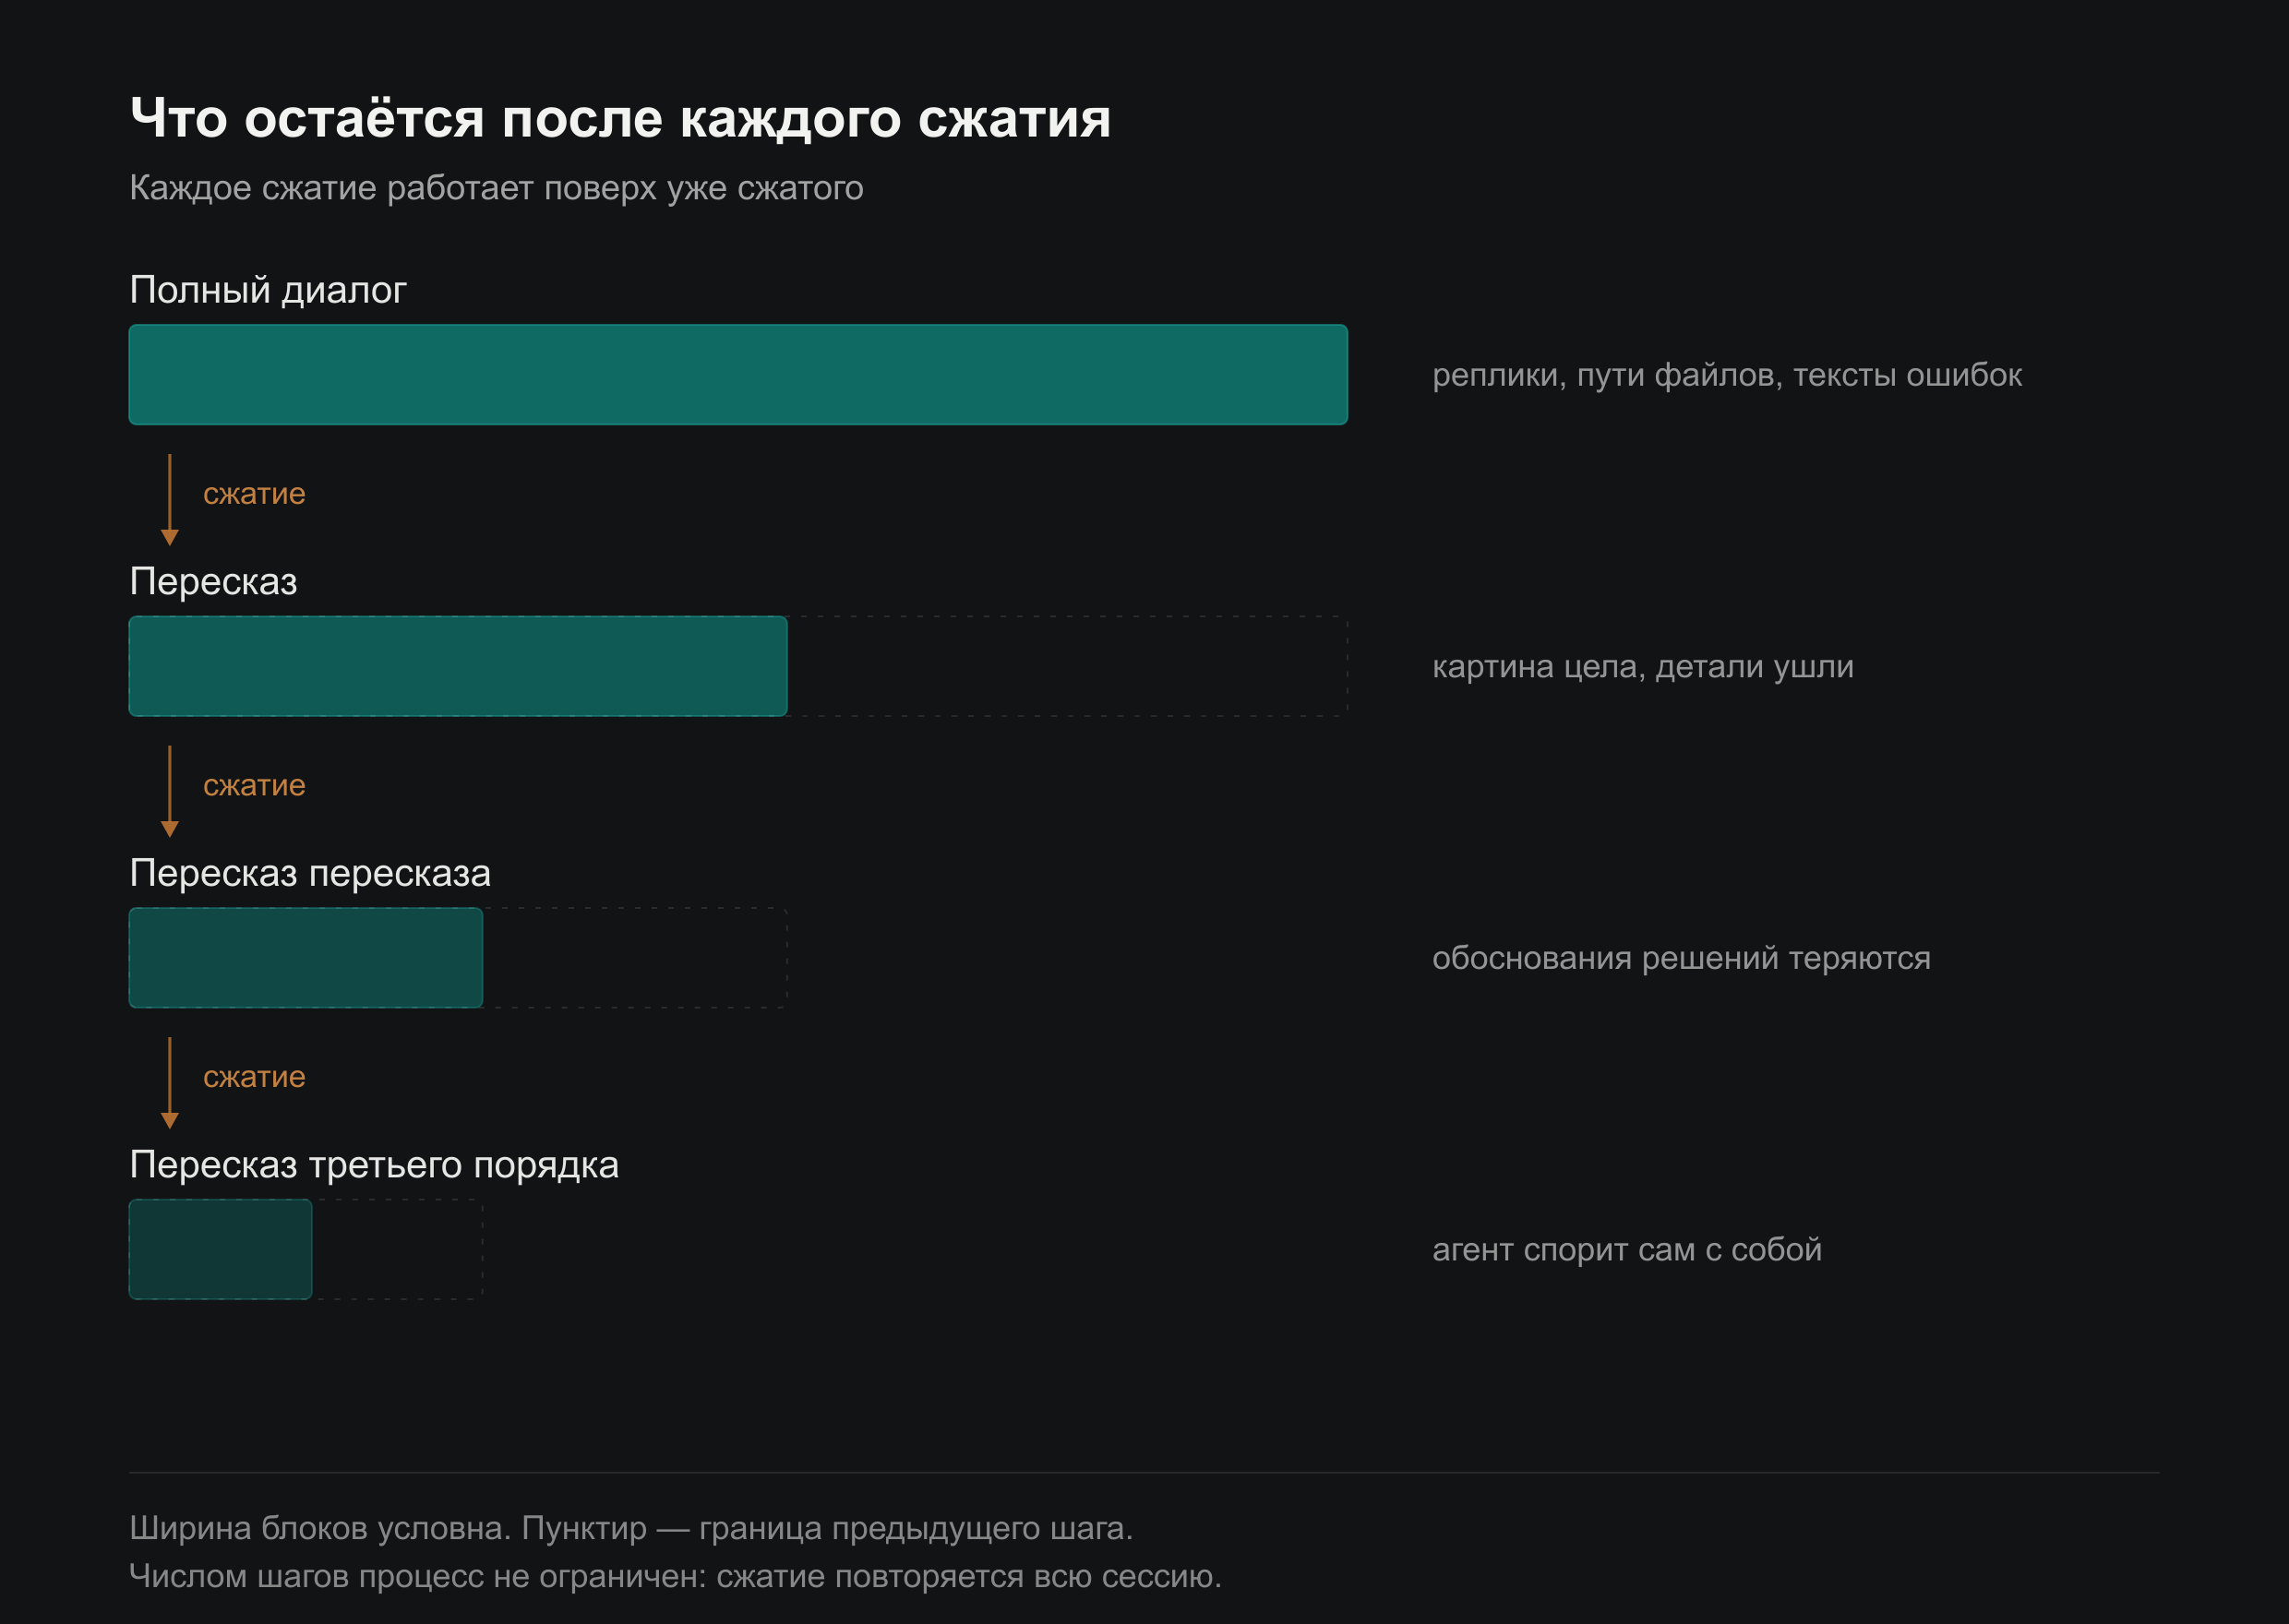
Второе сжатие работает уже над пересказом, а не над оригиналом. Третье — над пересказом пересказа. К четвёртому агент строит работу на фрагментах фрагментов, и отсюда ровно то поведение, с которого я начал: противоречия собственным ранним решениям, заново внесённые баги, правки по несуществующим путям.
Теряется при этом предсказуемое. Первыми уходят обоснования — остаётся «сделали так», исчезает «потому что». Следом точные пути файлов, дословные тексты ошибок, имена переменных. Общая картина держится дольше всего, а та самая точность, ради которой всё затевалось, вымывается первой.
Хуже всех переживают сжатие ограничения сессии — инструкции вида «сначала спроси меня, потом делай». Это не постоянная память, а временное условие текущего разговора, и живут они ровно до тех пор, пока сжимающий их сохраняет. Явление изучено отдельно: работа Lost in Compaction как раз про потерю побочных ограничений при сжатии.
Единого поведения тут нет вообще. Сравнение семи кодовых агентов показывает разброс от «жму, когда занята половина окна» до «тяну почти до самого края». Одни при сжатии удаляют, другие помечают куски как подавленные, и это обратимо. Одни сохраняют хвост разговора дословно, другие пересказывают всё. Часть инструментов позволяет автосжатие отключить.
Конкретные пороги я намеренно не привожу: они меняются от релиза к релизу и живут в чужих настройках. Полезнее понимать, что момент и способ сжатия у вашего инструмента — чьё-то проектное решение, а не свойство моделей. Это стоит один раз выяснить и, если можно, настроить под себя.
Где проходит граница с памятью
Всё это упирается в разделение, от которого зависит вся практика.
Контекст — то, что модель видит в момент ответа. Он собирается заново на каждый запрос и ограничен размером окна. Память — то, что доживает до следующего раза.
Сама сессия при этом никуда не пропадает: агенты давно сохраняют переписку на диск, и её можно поднять — в Claude Code это флаги --continue и --resume, транскрипт лежит обычным файлом и по умолчанию хранится месяц. Только вот поднять сессию означает залить сохранённый транскрипт обратно в окно. Он занимает ровно столько же места и деградирует ровно так же; восстанавливается доступ к тексту, а не понимание.
И это касается лишь той же сессии. В новую переезжают файлы, которые агент читает на старте, — всё остальное начинается с нуля. Автосжатие тут не помогает: оно укладывает разговор в доступное место и оставляет пересказ, но запоминания не происходит, происходит сжатие с потерями.
Отсюда простое следствие: всё, что должно пережить сессию, выносится наружу явно — в файл, в заметку, в коммит, в проектный документ. Всё, что осталось только в контексте, живёт до ближайшего сжатия. Это верно при любом размере окна: даже бесконечное окно одной сессии не переносит ничего в следующую. Как выстроить такой внешний слой, чтобы он не зависел от конкретного инструмента, я разбирал отдельно — в статье про переносимую память вне провайдера.
Что из этого следует на практике
Дальше — то, как я работаю сейчас, исходя из всего описанного выше. Разделю на две части: сначала то, что следует прямо из замеров, потом мои собственные привычки, за которые я не поручусь.
Что подпирается замерами
Ставить задачу целиком, а не разматывать по репликам. Самое сильное практическое следствие из всего найденного и та самая разница в 39%. Если требования известны, лучше собрать их в одно сообщение, чем выдавать порциями и уточнять по ходу. Модель, получившая задачу по кускам, рано угадывает, чего от неё хотят, и дальше защищает свою догадку.
Если модель уехала не туда — начинать заново, а не переубеждать. По той же работе, свернув в неверную сторону, модель оттуда не возвращается: она продолжает опираться на своё раннее решение. Спорить с ней дороже, чем открыть чистую сессию и поставить задачу заново, уже зная, где была развилка.
Приём для перезапуска: попросить модель собрать всё сказанное в сводку, сохранить её и начать новую сессию уже с этого текста. Авторы называют его среди работающих.
И честная граница этого приёма. Такие способы отыгрывают лишь пятую-шестую часть просадки. До уровня «задача поставлена целиком» они не вытягивают, и дополнительные размышления модели тут тоже не спасают. Смягчение, не лечение.
Не держать в контексте лишнее «на всякий случай». Отвлекающие фрагменты не просто занимают место, они активно портят ответ — это прямой вывод из замеров context rot.
Выносить результат в артефакт до того, как дойдёт до сжатия. Файл, коммит, запись в заметках — единственное, что переживает и сжатие, и конец сессии, и смену инструмента.
Как это делаю я
Здесь начинаются привычки, а не выводы. Работает у меня — не значит правильно вообще.
Главное правило простое: сессия заканчивается там, где закончился осмысленный кусок работы. Не когда упёрлось место, а когда есть что зафиксировать. В этот момент результат уходит в проектные файлы — что сделано, где остановились, что дальше, — и следующая сессия начинается с них, а не с попытки вспомнить. Получается бесшовно, при этом ничего не тащится из старого окна.
Автосжатие я обычно не жду: когда вижу, что окно набирается, сжимаю сам. Логика та же — автомат срабатывает по достижении порога, а не по смыслу, и не знает, какие детали мне ещё нужны. Мой собственный пересказ точнее того, что соберёт машина под давлением потолка. Признаю, это ручная работа, которую в принципе должен уметь делать инструмент, и в разных инструментах она устроена по-разному.
Продолжение, которое естественно вытекает из только что сделанного, оставляю в той же сессии — контекст там работает на меня. Новую тему начинаю с чистого листа.
Шумную работу — поиск по большому репозиторию, чтение здоровых файлов, разбор логов — стараюсь отдавать в отдельное окно, субагенту. Он делает работу у себя и возвращает сводку, мусор остаётся за границей моего контекста.
Есть приём, который я пока не довёл до привычки, хотя он измерен и работает: перед сжатием явно перечислить, что сохранить обязательно — пути файлов, принятые решения, ошибки, сигнатуры, тесты, переменные окружения, незакрытые задачи. Пересказ от этого становится заметно полнее почти без роста стоимости.
Сколько это стоит
У длины есть и прямая цена: контекст оплачивается каждым запросом заново, вся история едет в модель снова и снова.
Кеширование промпта это частично снимает. Если длинное начало запроса не меняется — системный промпт, набор инструментов, база знаний, — провайдер его кеширует, и повторное чтение обходится в разы дешевле обычного входа. Оговорок две. Кеширование не касается выходных токенов, а они и так дороже входных в несколько раз. И работает оно, только пока префикс не меняется: одна правка в начале промпта обнуляет кеш целиком.
Отдельно стоит знать про пороговые тарифы. У Anthropic до недавнего времени работало так: если запрос переваливал примерно за 200 тысяч токенов, он целиком уходил в премиальный тариф — вдвое дороже по входу и в полтора раза по выходу, причём наценка распространялась на весь запрос, а не на превышение. Один лишний абзац на границе мог удвоить стоимость вызова. В марте 2026 эту наценку убрали, и теперь цена за токен одна независимо от размера промпта. У других провайдеров пороговые тарифы кое-где ещё встречаются, так что при работе с длинными промптами имеет смысл посмотреть, нет ли такой границы у вашего.
Есть и эффект, ломающий наивные расчёты экономии. Цена за токен падает, команда в ответ гоняет больше циклов и длиннее контексты, потому что теперь может себе позволить, и общий счёт растёт. Агентные сценарии поднимают потребление токенов на порядок против оценки «по числу реплик».
Куда это движется
Рост окон замедляется. Причин три: архитектурные ограничения трансформера на больших длинах, убывающая отдача — для большинства задач короткое окно дешевле и работает не хуже, — и геометрический рост стоимости. Исключение делают для кодовых моделей, где обработка целой кодовой базы даёт понятную пользу.
Цена длины при этом падает, и отмена пороговых наценок — часть той же тенденции.
Но главное в другом. Деградация на длинном входе — свойство архитектуры и обучающего распределения, а не дефект, который закроют следующим релизом. Пока внимание распределяется между всеми парами токенов, увеличение окна само по себе проблему не снимает.
Поэтому работа идёт по двум направлениям сразу.
Первое — уход от квадратичного внимания. Гибридные архитектуры чередуют слои внимания со слоями пространства состояний: внимание оставляют там, где нужен точный поиск, остальную обработку последовательности отдают механизмам, линейным по длине. Экономия наглядная — на длинных окнах такие модели обходятся кратно меньшим объёмом кеша, чем классические на той же длине.
Кто и когда кого вытеснит — предсказывать не берусь, датам в этом жанре веры мало. Крупные ставки при этом стоят в противоположные стороны. Часть прогнозов отводит гибридам роль дефолта для новых фронтир-моделей уже к 2027 году: экономика вывода не оставит выбора. Против этого играет трёхлетний роадмап NVIDIA — неявная ставка на десятки миллиардов долларов на то, что трансформеры продержатся доминирующими как минимум до 2028 года. Такую инфраструктуру не строят под архитектуру, в которую не верят. Обе стороны — чьи-то деньги и чьи-то ожидания, а не знание о будущем.
Свою позицию сформулирую без дат. Трансформер в нынешнем виде выбрал интенсивный путь досуха: всё, что можно было взять от аккуратной работы с тем же механизмом внимания, уже взято. Дальше остаётся экстенсивный рост — больше памяти, больше вычислений, больше денег за ту же единицу качества. Квадратичность при этом никуда не девается, размывание внимания тоже. Потолок здесь архитектурный, а архитектурные потолки сдвигаются сменой конструкции; оптимизации внутри неё выигрывают время, но границу не переносят.
Самая громкая заявка на слом квадратичного барьера — SubQ. Стартап Subquadratic вышел из стелса в мае 2026 с моделью на 12 миллионов токенов контекста и архитектурой, которая масштабируется линейно. Заявлены десятки крат по скорости и цене против фронтир-моделей на миллионе токенов. Все бенчмарки самозаявленные, технической статьи нет, модель в закрытой бете, независимой проверки не было. Пока это заявка, а не результат.
Второе направление — память отдельным слоем рядом с контекстом. Управление тем, что попадает в окно, из отличительной особенности отдельных команд превращается в базовую инфраструктуру. Контекст и постоянная память складываются при этом как дополняющие слои, а не как конкурирующие подходы.
Что остаётся при любом раскладе
Окна вырастут ещё, а однажды сменится и сама архитектура. Работа при этом остаётся та же: решить, что заслуживает места в окне, и вынести наружу то, что должно пережить сессию. Этот навык переносится между инструментами лучше любого промпта и любой модели.
Короткие апдейты и разборы — в Telegram-канале Mind & Mesh: @takeshi_ku.