
Сначала три короткие сцены.
Агент отчитался: задача закрыта, отчёт собран, файл лежит в папке. Папка пуста.
Другой агент прошёл половину долгой задачи, когда процесс перезапустился. Начал с чистого листа, как ни в чём не бывало. Первая половина — часы и деньги — просто исчезла.
Третий запросил данные у внешнего сервиса и получил ошибку: истёк токен доступа. Он не остановился — пронёс текст ошибки через все следующие шаги и сдал отчёт, где в колонке с данными аккуратно свёрстано «401 Unauthorized».
Если вы гоняли агентов на реальных задачах, хотя бы один из этих сюжетов видели своими глазами — я на своих прогонах собрал все три. Реакция почти у всех одинаковая: модель слабовата, возьмём поумнее.
Дальше — почему модель поумнее этого не чинит, что за слой стоит между моделью и сделанной работой, из чего он собран, как ломается — и почему уже сегодня о нём стоит спрашивать каждого, кто продаёт вам «агента под ключ».
У слоя есть имя
Харнес (англ. harness — упряжь) — программный слой вокруг модели, который управляет её исполнением: ведёт цикл шагов, даёт модели инструменты, собирает ей контекст и проверяет результат.
Теперь то же самое в движении. Приходит задача. Харнес решает, что модель увидит в первом запросе, и получает от неё в ответ не готовую работу, а намерение: «прочитай файл», «запусти команду». Он исполняет это намерение в реальном мире, возвращает модели то, что вышло, — и так оборот за оборотом, пока не решит, что работа закончена. Ловить ошибки, помнить сделанное и отличать «закончена» от «модель сказала, что закончена» — тоже его работа.
Упряжь — точное слово. Сила лошади сама по себе телегу не везёт: везёт сила, переданная через упряжь. С моделью так же. Способность рассуждать сама по себе не открывает файлы, не вызывает API и не отличает «я написал код» от «код лежит в репозитории и проходит тесты».
По-русски харнес ещё называют обвязкой — слово уже прижилось в русскоязычных разборах. Дальше я пишу «харнес»: под этим термином живёт вся литература и замеры, о которых пойдёт речь, и искать дальше проще именно по нему.
Когда вы работаете с Claude Code, Codex или любым другим агентом — вы разговариваете не с моделью. Вы разговариваете с харнесом, внутри которого модель крутится. И заметная часть того, что вы привыкли считать умом или тупостью агента, живёт не в модели.
Звучит как маркетинговый тезис, но это измерено.
Одни модели, разные харнесы — разные агенты
В мае 2026-го команда Qihoo360 выпустила Harness-Bench — замер, устроенный как чистый факторный эксперимент: меняется одна переменная, всё остальное закреплено. Одни и те же задачи. Одни и те же модели — восемь штук, от фронтирных закрытых до открытых. Меняется только харнес: шесть открытых проектов с разной философией, каждый работал в своём штатном поведении — протокол его не подменял.
Разрыв между лучшим и худшим харнесом — почти 24 балла из ста: 76,2 против 52,4 по сводной оценке. Ещё раз: модели те же самые. Задачи те же самые. Разница — четверть всей шкалы, и взялась она не из модели и не из сложности задач: из обвязки.
Сразу граница, чтобы число не выросло в голове больше, чем оно есть. Это песочница: изолированные офлайновые задачи, без живых сервисов, без меняющегося внешнего мира, без долгой продакшн-памяти. Авторы сами это оговаривают — такова цена воспроизводимости. Перенести их цифры один в один на вашу задачу нельзя. Перенести вывод — можно: слой между моделью и результатом вносит вклад, сравнимый с выбором модели.
Для тех, кто собирает. Протокол: 106 задач, собранных из практических паттернов агентной работы и вручную проверенных на решаемость и проверяемость; 6 настраиваемых харнесов × 8 моделей × все задачи = 5 088 траекторий, плюс 106 у Codex — его считали отдельно, он не даёт менять модель под собой. Оценка двухслойная: жёсткий оракул результата плюс процессная рубрика (уместность инструментов, консистентность, устойчивость); судья процесса — одна фиксированная модель на все прогоны. У каждой траектории сохранены артефакты, трейс исполнения и расход — можно копать глубже финальной галочки.
К баллам прилагается счёт, и он интереснее баллов.
Дороже не значит лучше
Счёт за агента считают в токенах — единицах объёма текста, который модель прочитала и написала. Так вот: на одну и ту же работу шесть харнесов потратили токенов с разбросом в два с половиной раза. При этом самый дешёвый из шести оказался самым результативным. А проект, который позиционирует себя как лёгкий и бережный к ресурсам, сжёг больше всех.
Отдельный сюжет — харнес, сделавший втрое больше ходов, чем лидер, и потративший вдвое больше токенов. Первого места этот расход ему не купил — только второе: каждая лишняя итерация стоила денег и не конвертировалась в качество один к одному.
Привычная интуиция «работает дольше и обстоятельнее — значит, старается» здесь не работает. Длинная траектория с тем же успехом означает, что агент кружит: переспрашивает сам себя, перечитывает то, что уже читал, чинит то, что не ломалось. И все эти лишние обороты вы оплачиваете так же, как полезные, — тариф их не различает.
Для тех, кто собирает. Сырые токены — вообще плохая мера, и не только из-за цены. Свежая работа (май 2026) формулирует, почему: расход не отличает полезную обратную связь от повторной и нестабильной. Предлагаемая замена — считать только информативную, валидную, неповторную и удержанную обратную связь (effective feedback compute). Масштабирование харнеса упирается в устойчивую, достаточную для задачи обратную связь, не в объём вычислений как таковой.
Из чего харнес состоит
Теперь сам слой. Я раскладываю его на четыре обязанности — ниже покажу, что это согласуется с тем, как его режут другие, и почему все режут по-разному.
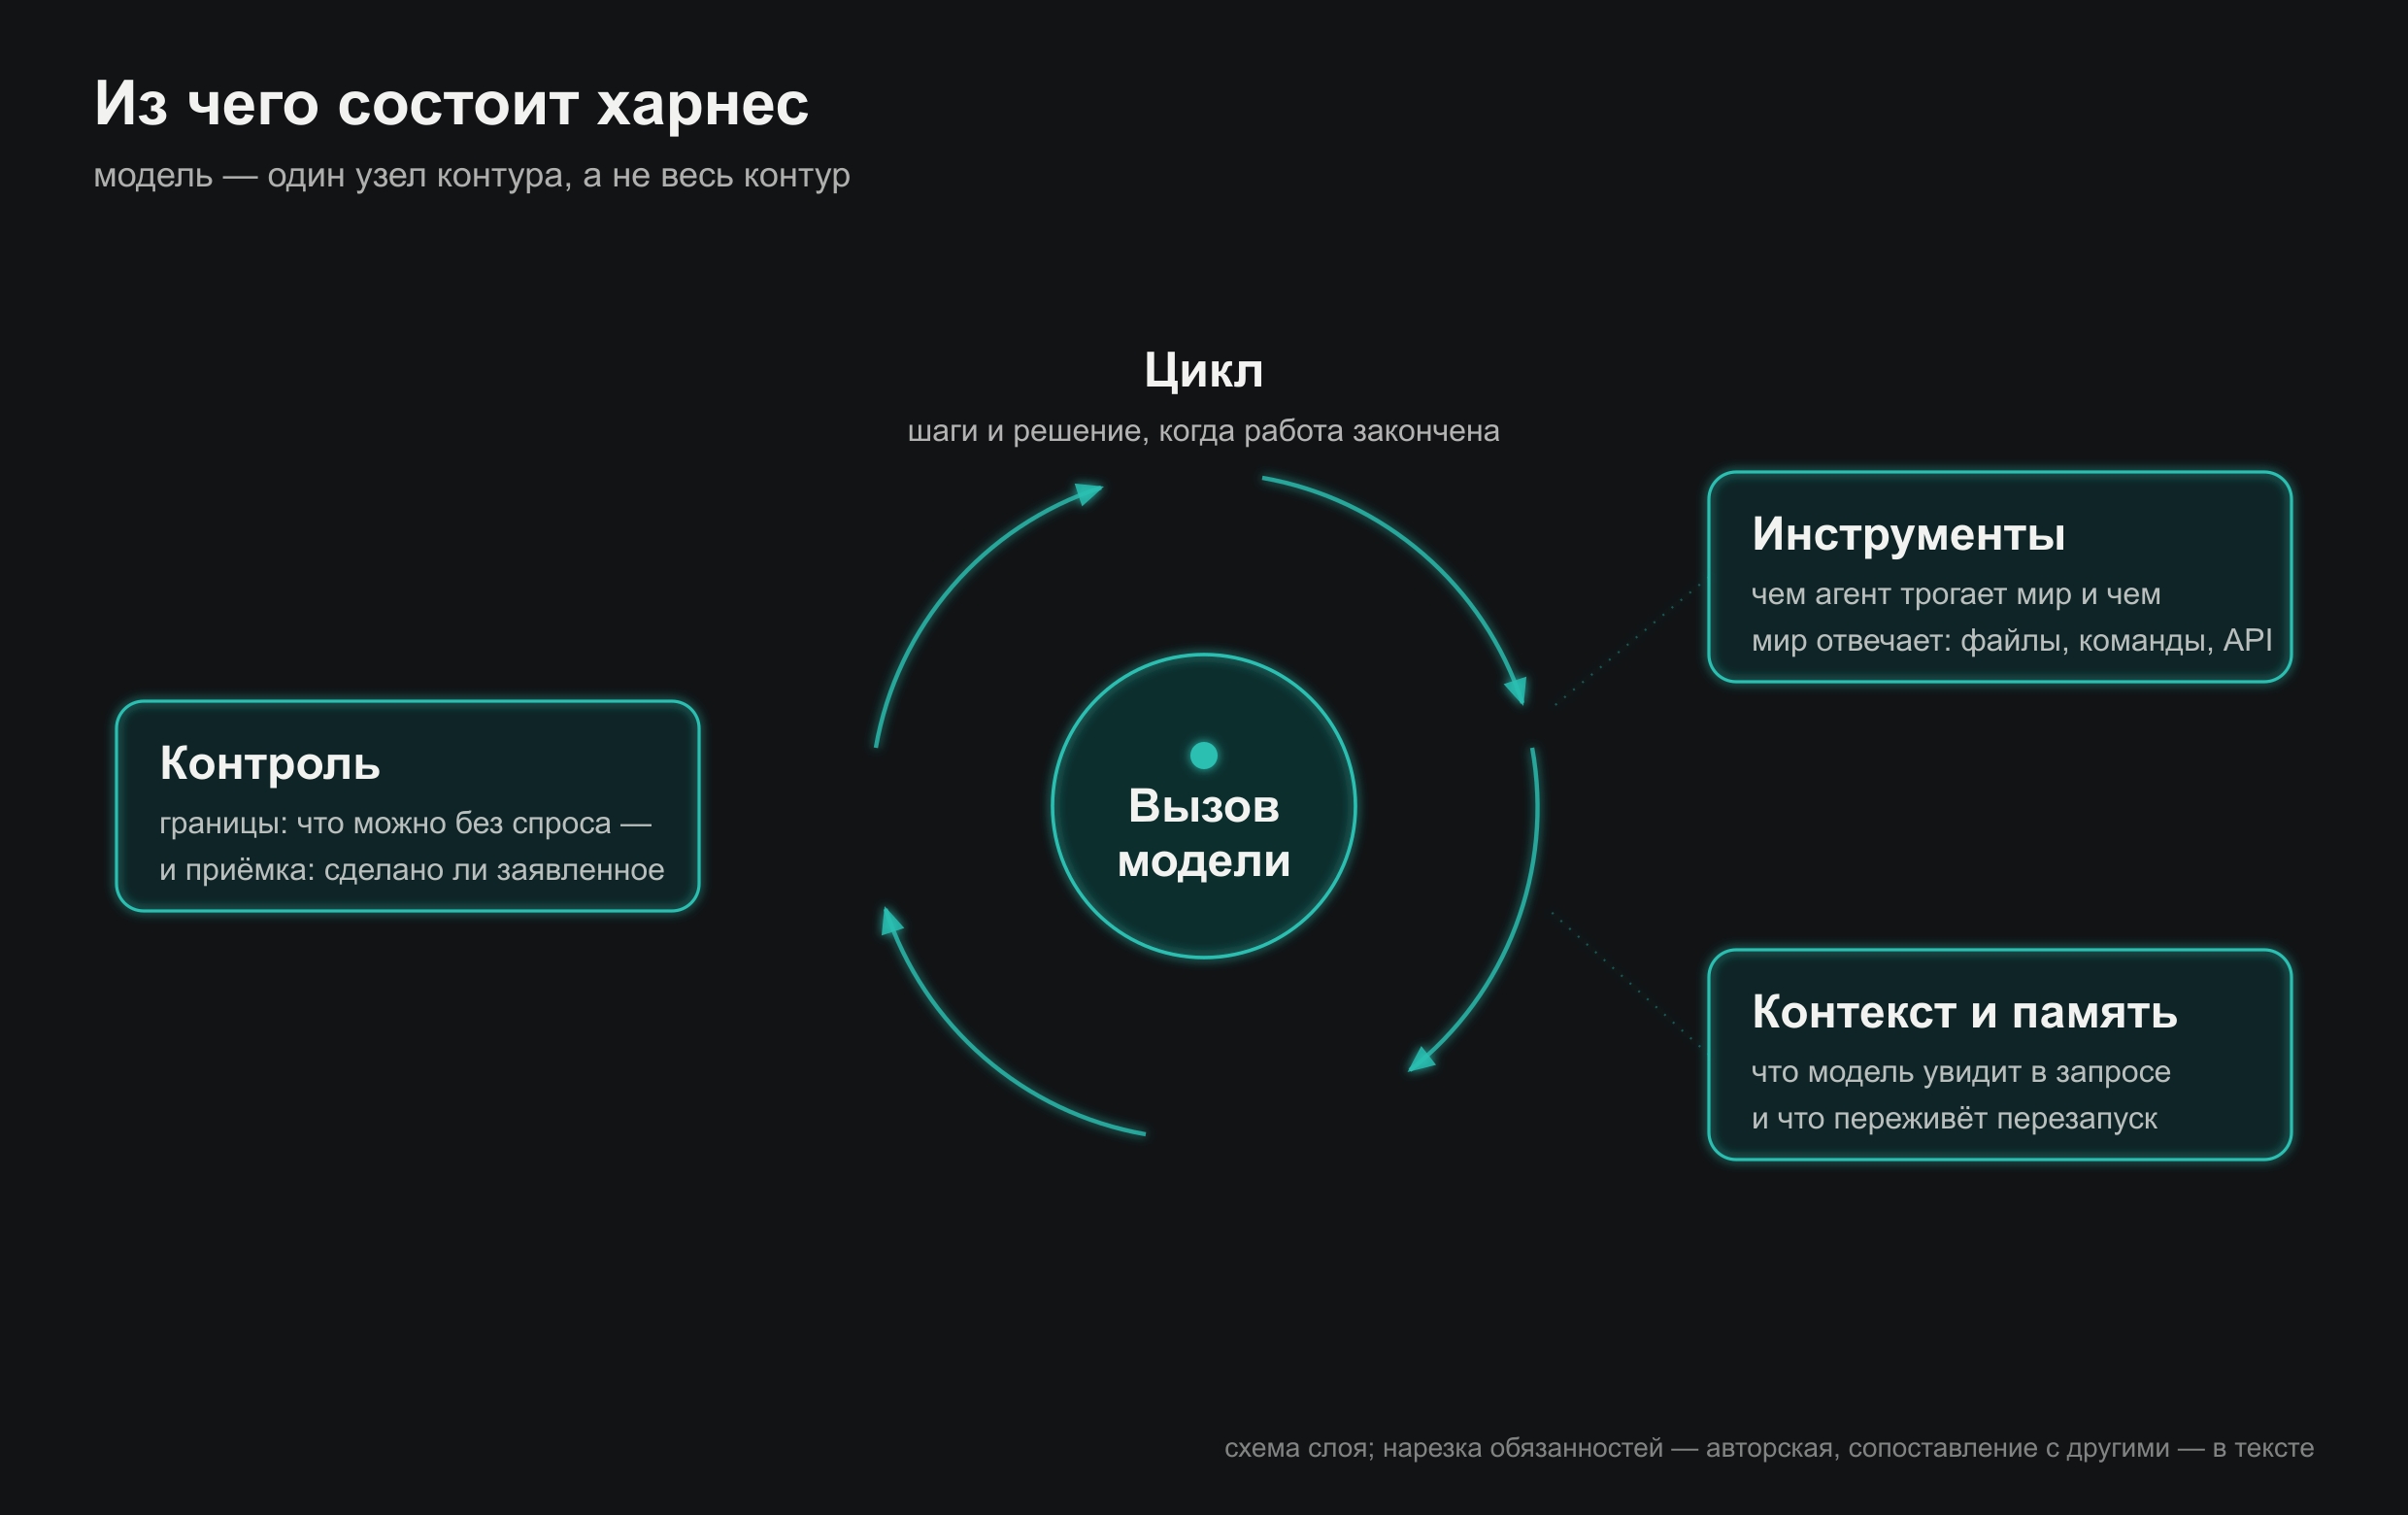
Цикл. Агент работает шагами: собрать контекст → вызвать модель → разобрать ответ → выполнить действие → результат обратно в контекст → следующий шаг. Кто-то должен крутить эту петлю, решать, что считается завершением, ограничивать число оборотов и понимать, что делать, когда шаг упал. Модель этого не делает — она живёт внутри одного оборота и не видит петлю целиком.
Инструменты. Всё, чем агент трогает мир и чем мир отвечает ему: чтение и запись файлов, команды, запросы к API, поиск. У каждого инструмента — описание, которое модель видит, и разбор ответа модели в реальный вызов. Здесь же решается, что агенту доступно в принципе: агент без инструмента чтения логов не прочитает логи, каким бы умным ни был.
Контекст и память. Модель видит только то, что ей положили в запрос, — я разбирал это в статье про контекстное окно. Харнес решает, что именно положить: какие куски истории, какие файлы, какие результаты прошлых шагов. Сюда же — память за пределами одного запроса: заметки на диске, состояние задачи, всё, что должно пережить перезапуск процесса. Окно кончается, процесс умирает; выживает то, что харнес вынес наружу. Свою память агентов я поэтому держу файлами в git, вне провайдера, — как это устроено, разбирал в «Переносимой памяти».
Контроль. Границы и приёмка: что агенту можно без спроса, что только с подтверждением человека, что нельзя никогда. И проверка результата: соответствует ли сделанное заявленному — файл существует, формат правильный, тесты проходят. Без этой обязанности «готово» агента — просто слово.
Теперь про число коробочек. Июньский обзор агентных систем режет тот же слой на шесть обязанностей: наблюдение, контекст, управление, действие, состояние, проверка. Они без остатка сворачиваются в мои четыре: наблюдение и действие — это инструменты, контекст и состояние — контекст и память, управление — цикл, проверка — контроль. В разборе на vc.ru компонентов двенадцать. Microsoft, добавив харнес в свой Agent Framework, определяет его как «слой, где рассуждение модели встречается с реальным исполнением» и перечисляет свой набор: доступ к шеллу и файлам, подтверждения человека, управление контекстом в долгих сессиях.
Все считают по-разному, и это не бардак в молодой дисциплине. Границы между обязанностями условны, и однозначно правильной нарезки не существует. Рабочий вопрос звучит в момент поломки, и он один: какой обязанности не хватило?
Для тех, кто собирает. Четыре обязанности в живом коде выглядят прозаично. Цикл —
whileс лимитом итераций, условием выхода и обработкой упавшего шага. Инструменты — схемы вызовов, которые видит модель, парсер её ответа и маршрутизация на реальные функции. Контекст — сборка промпта на каждый оборот, компакция при переполнении, память как файлы на диске. Контроль — белые списки команд, точки подтверждения, песочница, валидация выхода по схеме. Ни в одной из четырёх частей нет ничего интеллектуального — и в этом суть: интеллект арендуется у модели, надёжность пишется руками.
Как харнес ломается
Авторы Harness-Bench разобрали провалившиеся траектории и сгруппировали типовые поломки. Список короткий, но он размечает почти всё, что вы видели у агентов сами.
Результат не в той форме, которую можно проверить. Самая частая поломка — больше трети провалов. Агент по существу справился, но сдал работу мимо контракта: сломанный формат, пропущенное обязательное поле, отчёт без требуемой строки. Среда не может это принять — по правилам приёмки работа не сделана.
Ошибка инструмента без восстановления. Вызов упал или команду заблокировали — а дальше ни повтора с исправлением, ни пересмотра плана. Агент либо продолжает, будто ошибки не было, либо честно останавливается посреди дороги.
Утверждение без основания. Источники прочитаны не все, а выводы написаны уверенно; проверка, которую требовала задача, пропущена. В отчёте это выглядит как знание — по трейсу видно, что это догадка.
Сделано, но не зафиксировано. Рассуждение правдоподобное, решение по сути есть — а требуемый артефакт в рабочее пространство не записан. То самое «готово» при пустой папке.
Потеряно на перезапуске. Прогресс не сохранялся наружу, и любой обрыв процесса отбрасывает задачу к нулю.
Все три сюжета из начала статьи — из этого списка: пустая папка — «сделано, но не зафиксировано», старт с чистого листа — «потеряно на перезапуске», таблица с «401 Unauthorized» — «ошибка без восстановления». Я не подбирал сцену под таксономию — просто поломки агентов типовые, и это хорошая новость: типовое чинится системно.
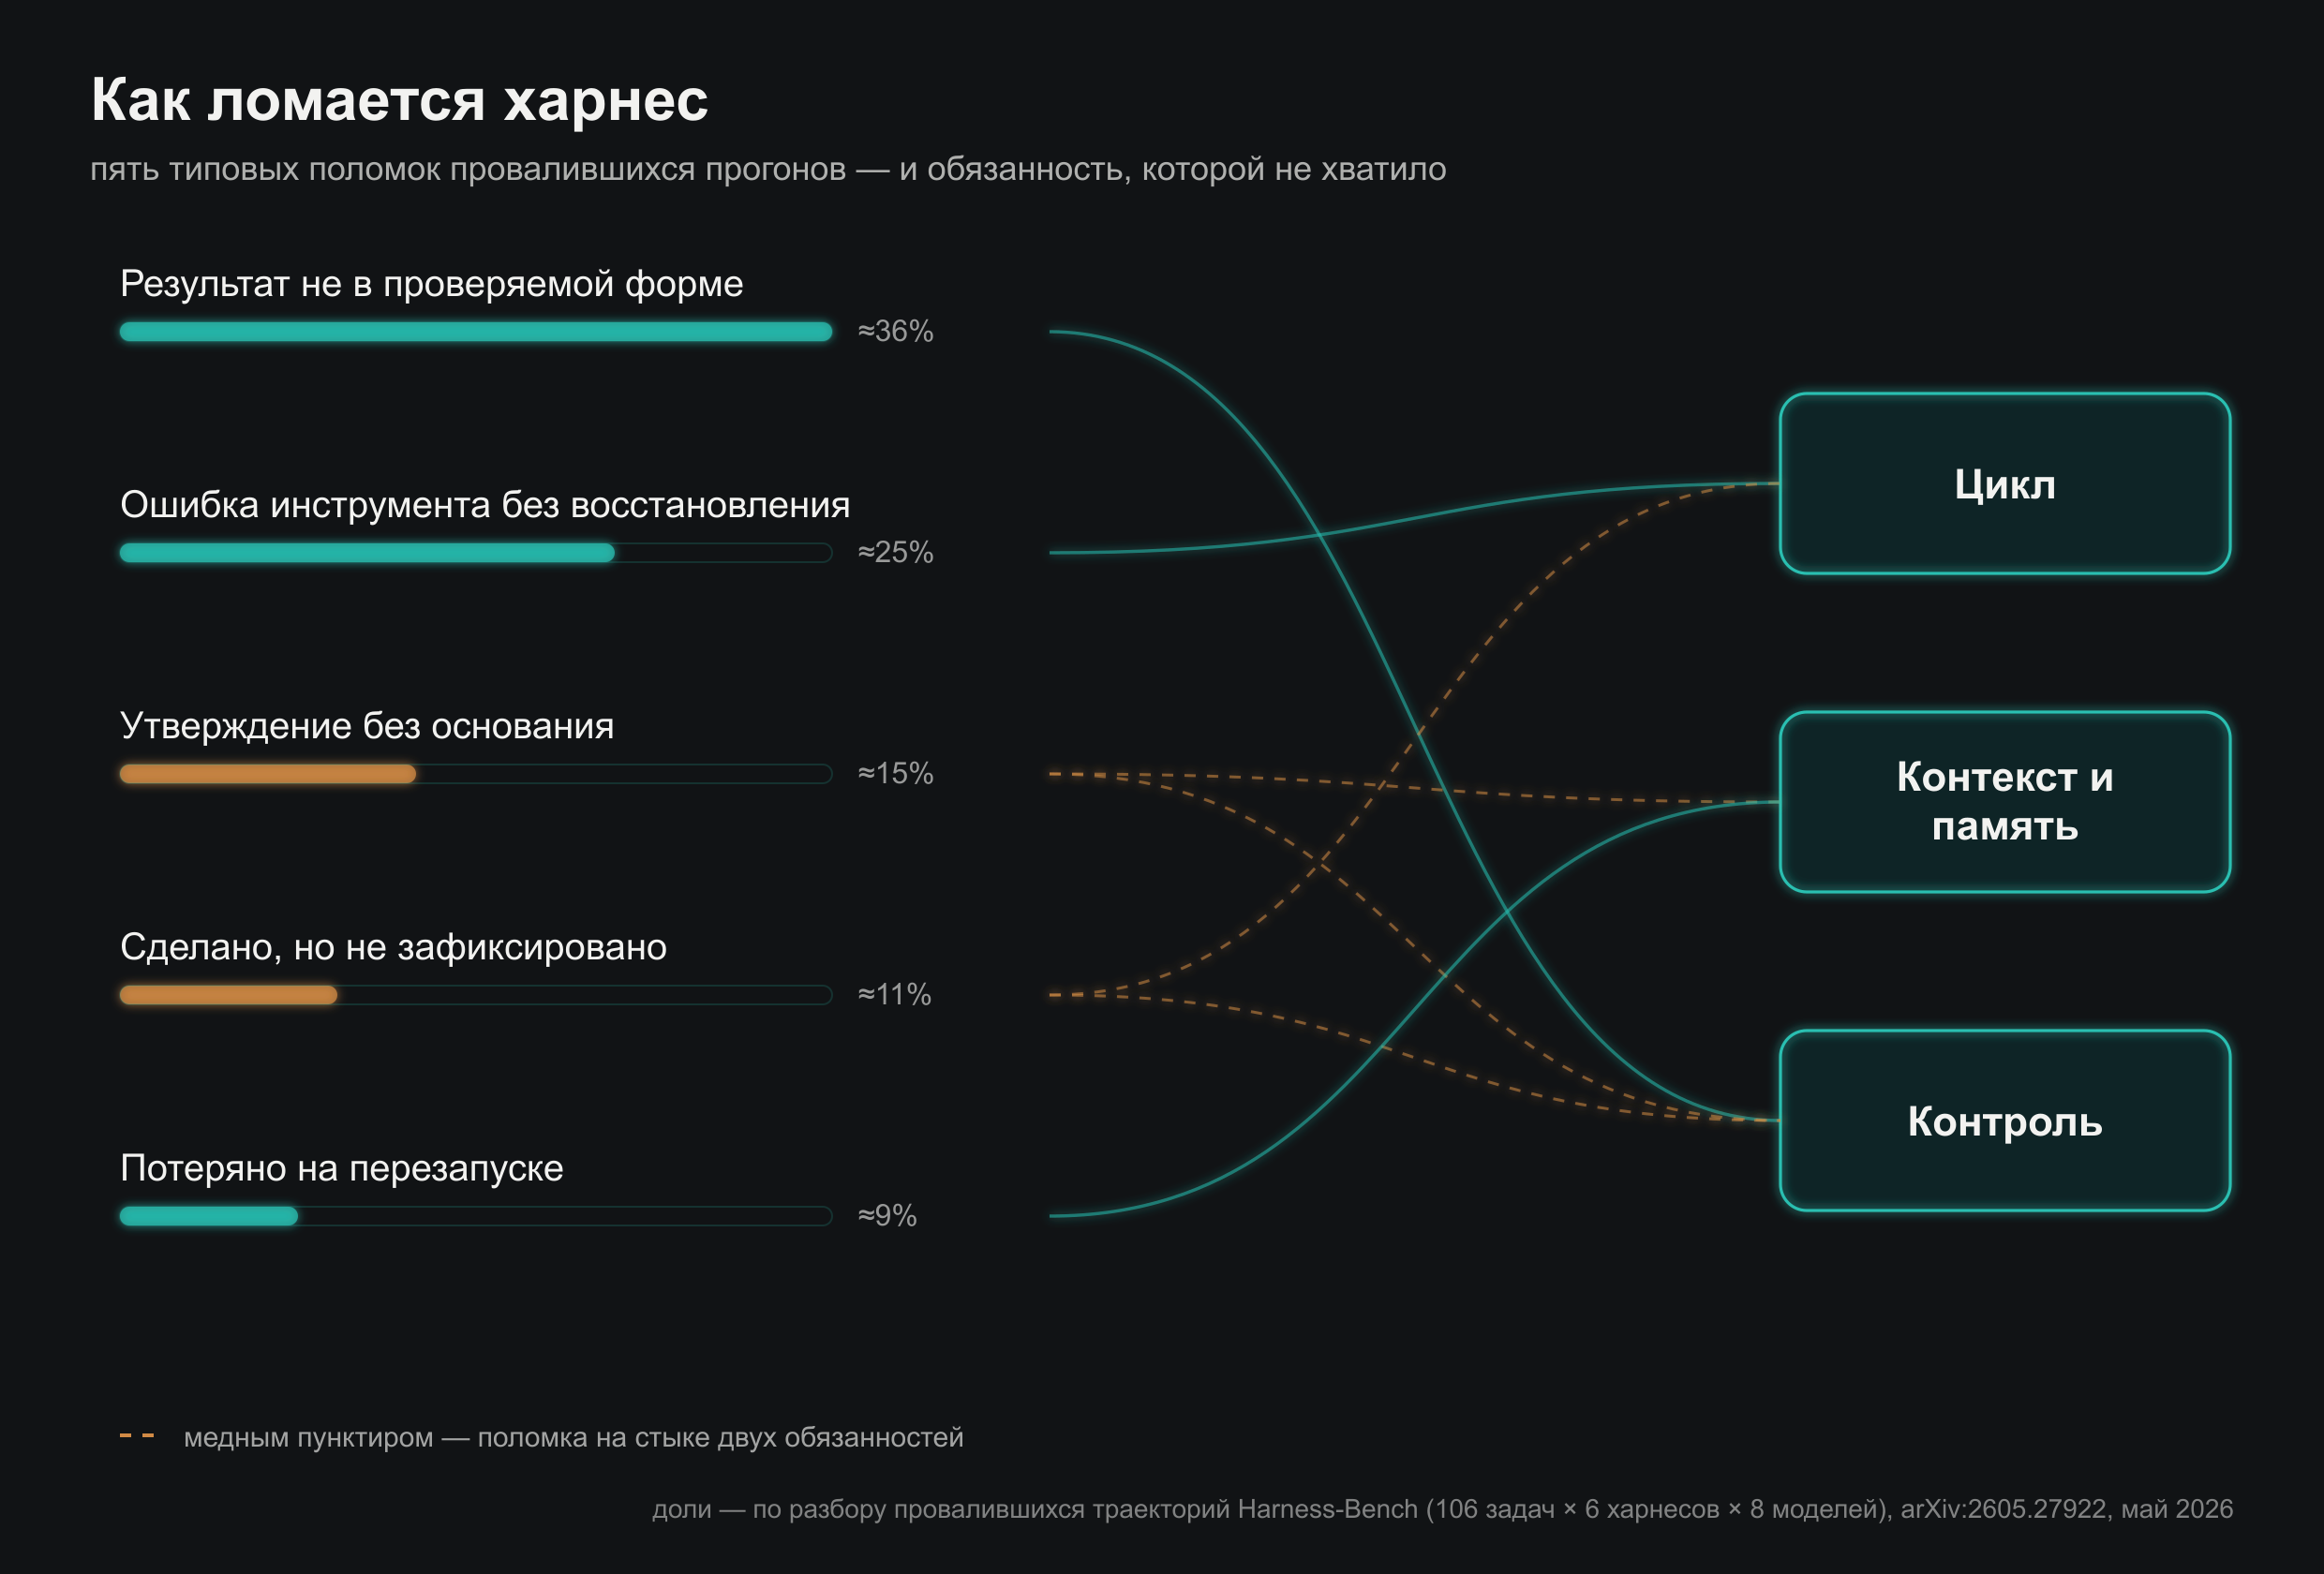
Каждая поломка указывает на обязанность из прошлого раздела, а некоторые — сразу на две. «Сделано, но не зафиксировано» — это стык цикла и контроля: шаг фиксации не был обязательным этапом петли, и приёмка не проверила артефакт. Поломки на стыках — ещё одна причина, почему у всех авторов разное число коробочек: границы проходят по живому.
Для тех, кто собирает. Анатомия самой частой поломки, контрактной. Модель выдала связный JSON-подобный текст — с лишней запятой, без обязательного поля, с числом в строке вместо числа. Рассуждение вокруг локально безупречно. Дальше два варианта. Харнес с валидацией выхода ловит расхождение со схемой и возвращает модели на исправление — цикл делает ещё оборот, задача сдаётся. Харнес без валидации передаёт текст дальше как есть — и задача проваливается на приёмке, хотя интеллекта в ней хватало. Разница между «прошёл» и «провалился» здесь — страница кода валидатора, не миллиарды параметров.
Почему более умная модель этого не чинит
У авторов замера есть понятие, которое сшивает всё сказанное в одну мысль: соответствие исполнения (execution alignment). Харнес удерживает совпадение между тремя вещами — тем, о чём модель рассуждает; тем, что реально записано в рабочем пространстве; тем, что будет проверяться на приёмке. Пока три картины совпадают, агент работает. Все пять поломок — разные способы их расхождения: рассуждение уехало от файлов, файлы — от контракта приёмки.
Смена модели двигает только первую из трёх картин. Модель поумнее рассуждает лучше — но если петля не считает фиксацию артефакта обязательным шагом, а приёмка не сверяет сделанное с заявленным, расходиться картины будут всё равно — только быстрее и красноречивее.
В замере есть и прямая проверка этой логики. Для каждой модели посчитали, насколько её результат гуляет между шестью харнесами. У сильных моделей разброс меньше — они дотягивают даже в плохой обвязке. У слабых разброс большой: та же модель в одном харнесе работает, в другом разваливается.
Отсюда практическое следствие, которое я почти не встречаю в текстах про агентов. Если вы гоняете локальные или дешёвые модели — харнес решает у вас больше, чем у тех, кто сидит на фронтире. Экономия на модели без вложений в обвязку не экономия: вы забрали интеллект и не добавили надёжность, которая его страхует.
И отсюда же — ответ на тезис, который уже звучит в русскоязычных разборах: модели усиливаются, значит, обвязки будут истончаться. Наполовину подтверждается: чувствительность к харнесу у сильных моделей действительно ниже, часть подпорок отомрёт. Но «тонкий» — это ярлык из описания проекта. А ярлыки, как сейчас увидим, с замером не сходятся.
Наклейка против замера
У шести харнесов из Harness-Bench разное позиционирование, почти маркетинговые роли: многоканальный ассистент-рантайм с плагинами и большой экосистемой (OpenClaw), самохостящийся системный рантайм (ZeroClaw), исследовательский агент с памятью и навыками (Hermes), защищённый локальный со встроенной песочницей (Moltis), легковесный с упором на экономию ресурсов (NullClaw), сверхлёгкий с маленьким ядром цикла (NanoBot). Названия здесь — для проверяемости; продукты в этой нише живут недолго, поэтому смотреть стоит не на имена, а на то, как ярлык соотнёсся с результатом.
Выиграл сверхлёгкий — и он же потратил меньше всех. Заявленный легковесным и экономным потратил больше всех — и пришёл четвёртым. Исследовательский, с самой богатой машинерией памяти и навыков, сделал втрое больше ходов, чем победитель, — и стал вторым: достойно, но каждый лишний оборот оплачен, а вершину так и не купил. Харнес с самой большой экосистемой плагинов пришёл последним.
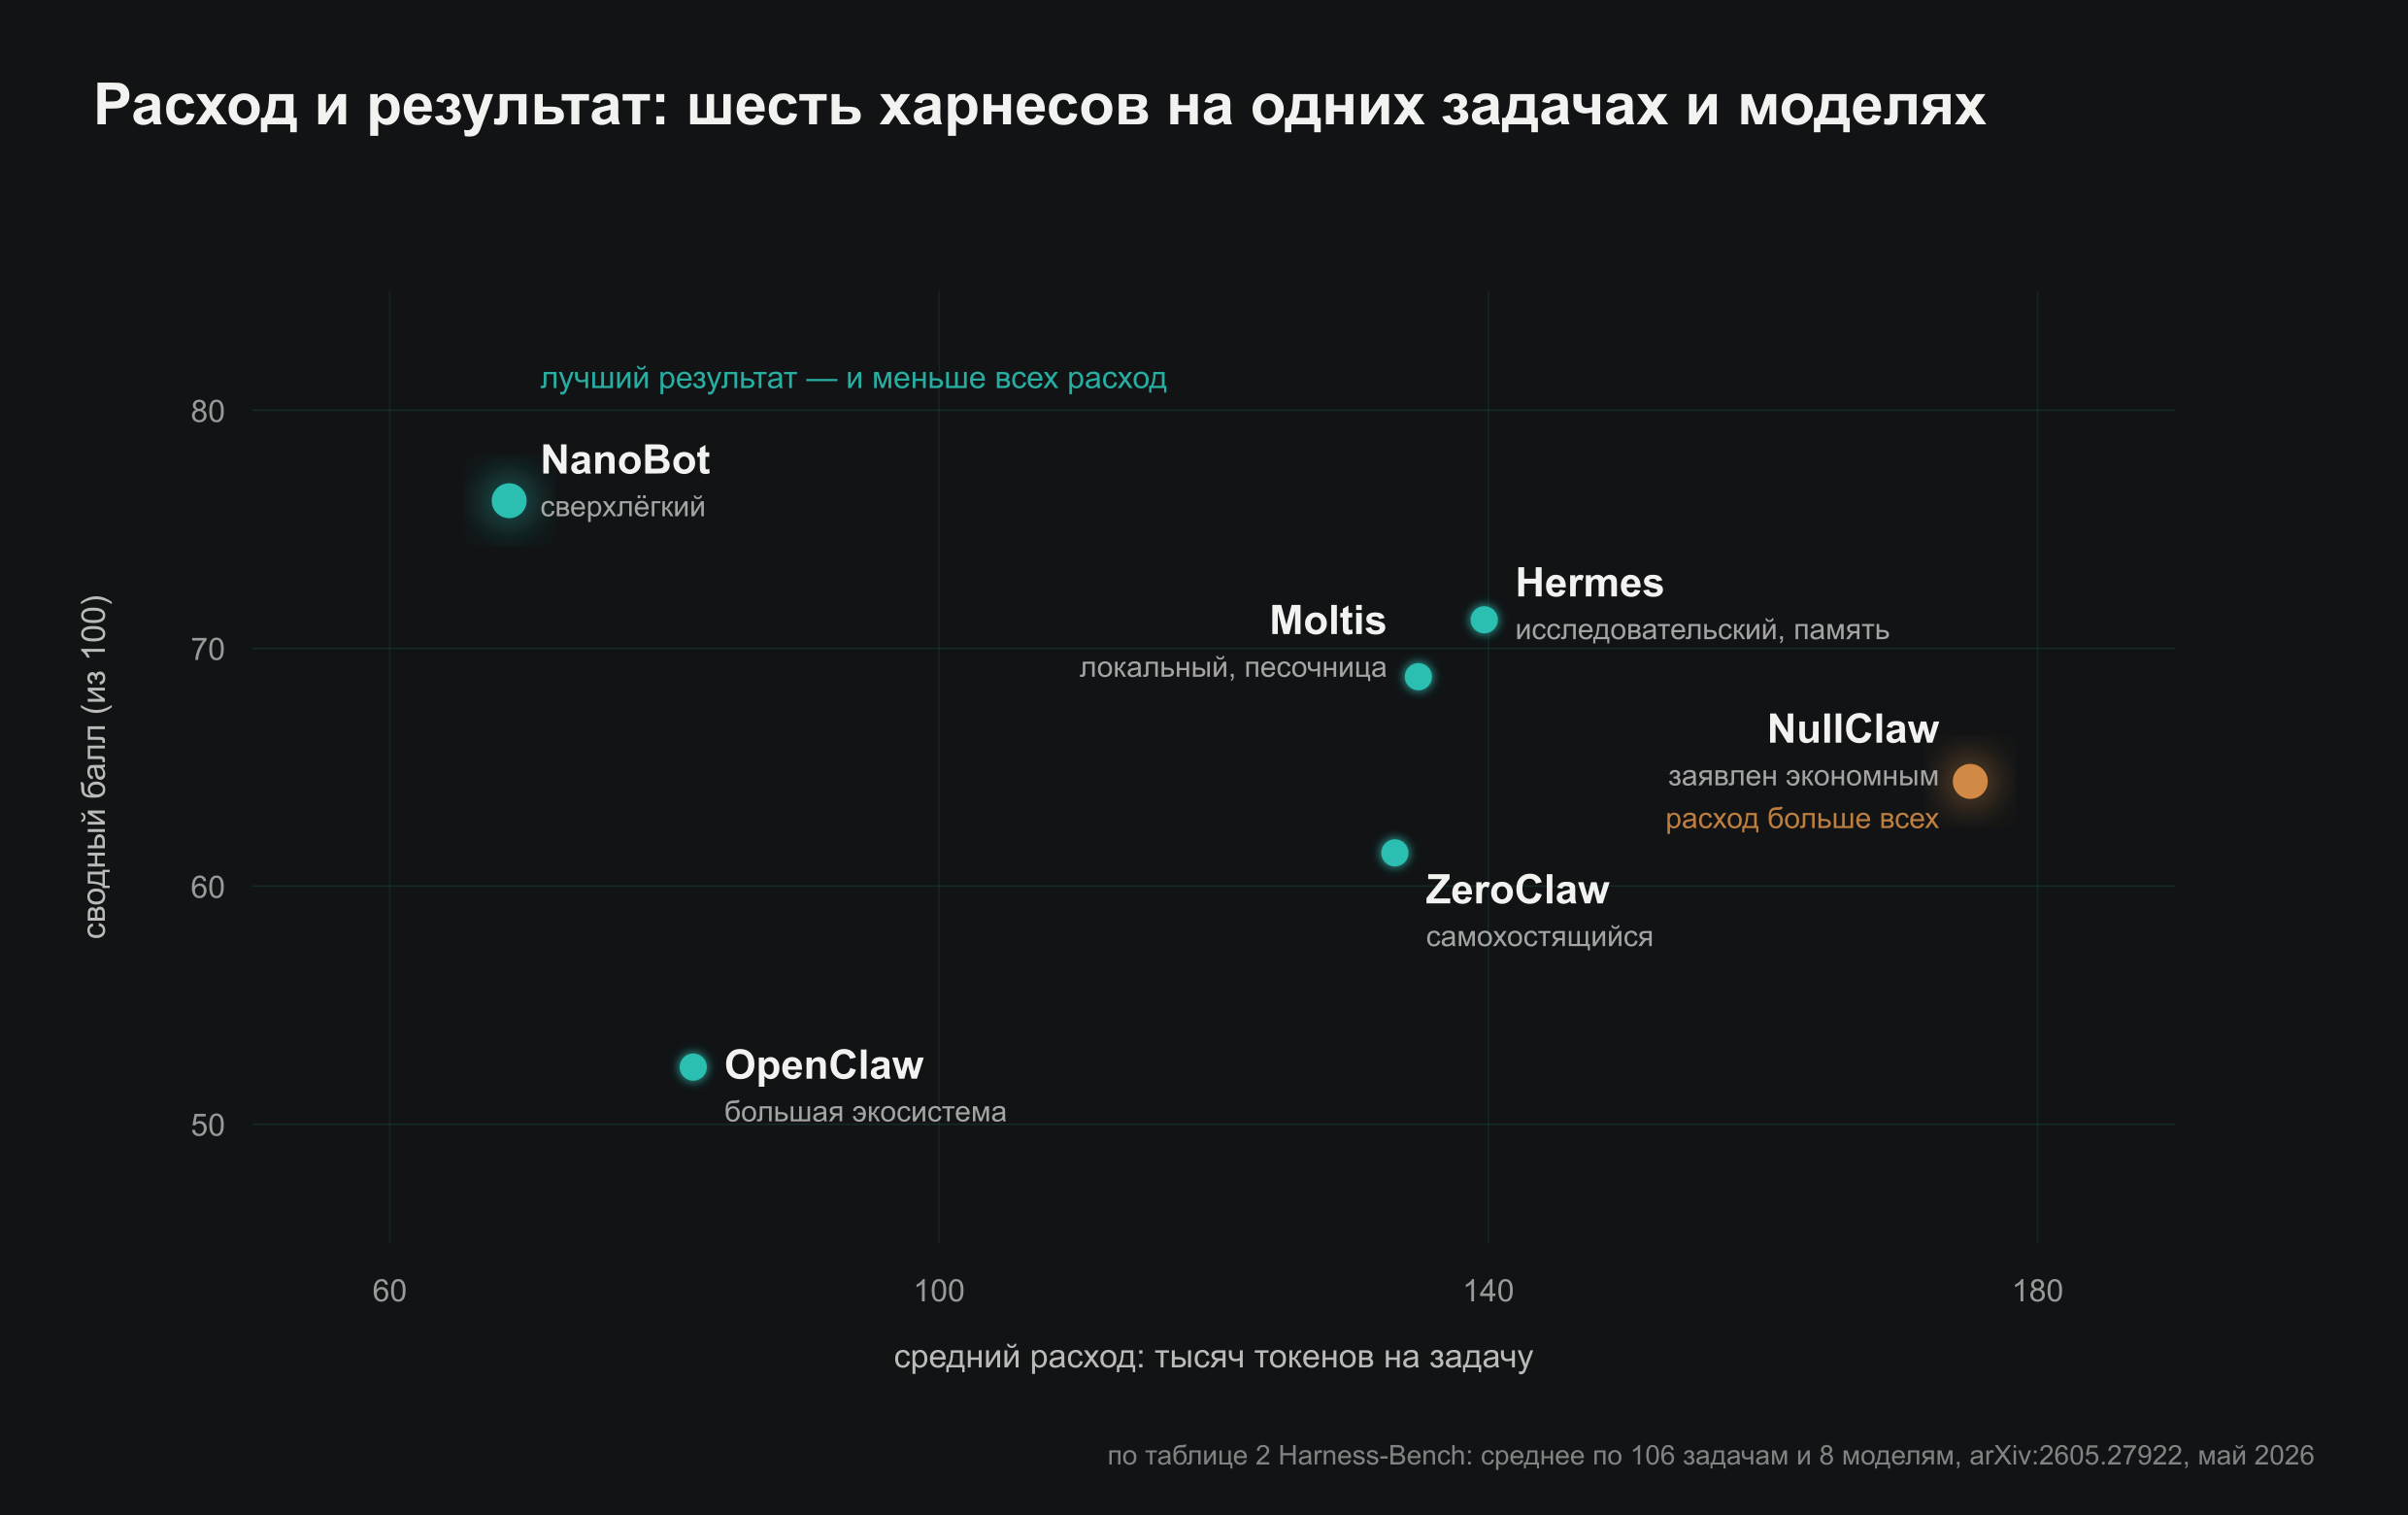
Ярлык не предсказал ничего — ни в плюс, ни в минус. «Лёгкость» одному проекту сопутствовала в победе, другому — в самом дорогом провале. Богатство экосистемы не помогло, богатство памяти не окупилось. А то, что действительно объясняет результат — как обвязка держит четыре обязанности, — снаружи по описанию проекта не видно вовсе.
И одна строка в таблице замера, о которой обзоры молчат. Колонка «безопасность» у всех шести — ровно сто из ста. Метрика, которая не отличила ни одного участника от другого, не измерила ничего: либо задачи не создавали реального риска, либо шкала не умеет его ловить. Этот случай стоит держать в голове при чтении любой вендорской таблицы, где у всех галочки.
Что будет дальше
Здесь начинается моя оценка — помечаю это честно, дальше меньше замеров и больше позиции.
Сдвиг, который уже виден по датам. В апреле 2026-го Microsoft довёл Agent Framework до стабильного релиза, к началу лета — добавил в него собственный харнес: компакцию контекста, файловую память между ходами, подтверждения человека с правилами «больше не спрашивать», фоновых субагентов. Так сейчас движутся большие платформы: продают уже не конструктор, из которого вы соберёте агента, а место, где агент исполняется под надзором. Харнес перестаёт быть тем, что каждая команда пишет себе сама, — и становится тем, что выбирают, как когда-то выбирали базу данных. Возможно, дальше слой уйдёт ещё глубже под капот: станет нативнее, порог входа ниже, и спрашивать о харнесе вслух будет так же странно, как сегодня — о файловой системе телефона. Слой это не отменит — только перенесёт выбор: вместо «какой харнес» вы будете выбирать платформу, где он уже решён за вас, не видя, что именно решили.
Открытые проблемы при этом никуда не делись, и тот же июньский обзор называет их прямо. Оценка по ценности: процент прохождения задач не отличает работу, которая принесла пользу, от работы, которая формально закрыта, — а платят за первое. Переносимость: харнес, вылизанный под кодовые задачи, не обязан работать для исследовательских, и наоборот. Со-эволюция: модели начинают обучать под конкретные обвязки, а обвязки строить под конкретные модели — и универсальные сравнения будут расходиться с реальностью ещё сильнее.
И главное следствие, к которому ведёт вся эта статья. Если результат — свойство пары «модель + харнес», то и заявлять способность агента честно можно только парой. «Наш агент решает 80% задач» без указания обвязки — цифра ни о чём: тот же замер показал от 52 до 76 на одних и тех же моделях. Я думаю, указание пары постепенно станет нормой приличия в отчётах и бенчмарках — как неприлично мерить скорость кода, не назвав железо. Пока это не так, каждая непарная цифра — повод для вопроса.
Что с этим делать
Если агент врёт про сделанное, теряет работу на перезапуске, игнорирует ошибки инструментов или сдаёт результат каждый раз в новой форме — это харнес, не модель. Сменой модели это не лечится: все четыре симптома живут в цикле, контроле и памяти, а их вы не меняли.
Вопросы, которые стоит задавать — подрядчику, вендору, своей команде:
— На каком харнесе это работает и что происходит, когда инструмент возвращает ошибку? «Модель разберётся» — неправильный ответ: разбирается петля, и она либо написана, либо нет.
— Переживает ли задача перезапуск процесса? Где лежит прогресс, кроме контекстного окна?
— В какой форме сдаётся результат и кто его проверяет, кроме самой модели? Есть ли приёмка, которая отличит «готово» от сделанного?
— На какой связке «модель + харнес» намерили проценты из вашей презентации — и что будет с ними на другой связке?
По ответам быстро понятно, с кем вы разговариваете: у того, кто строил обвязку всерьёз, на каждый вопрос найдётся скучный конкретный ответ. Гладкая презентация без деталей — плохой знак.
Для тех, кто собирает. Тот же чеклист, обращённый внутрь, по четырём обязанностям. Цикл: есть ли лимит оборотов и что происходит на упавшем шаге — повтор, пересмотр плана или тихое продолжение? Инструменты: валидируется ли выход модели до исполнения и что агенту физически недоступно? Контекст и память: что выживет, если убить процесс прямо сейчас? Контроль: какая проверка отличает сделанную задачу от заявленной — и запускается ли она всегда или «когда не забыли»?
Модель вы арендуете, и завтра она у всех будет другой. Харнес — это то, что остаётся: ваши границы, ваша приёмка, ваша память. По нему и видно, есть у вас агент — или подписка на чат с инструментами.
Короткие апдейты и разборы — в Telegram-канале Mind & Mesh: @takeshi_ku.